
Wikimedia Bela Training AI sebagai Fair Use; Tolak RAG Tanpa Kredit
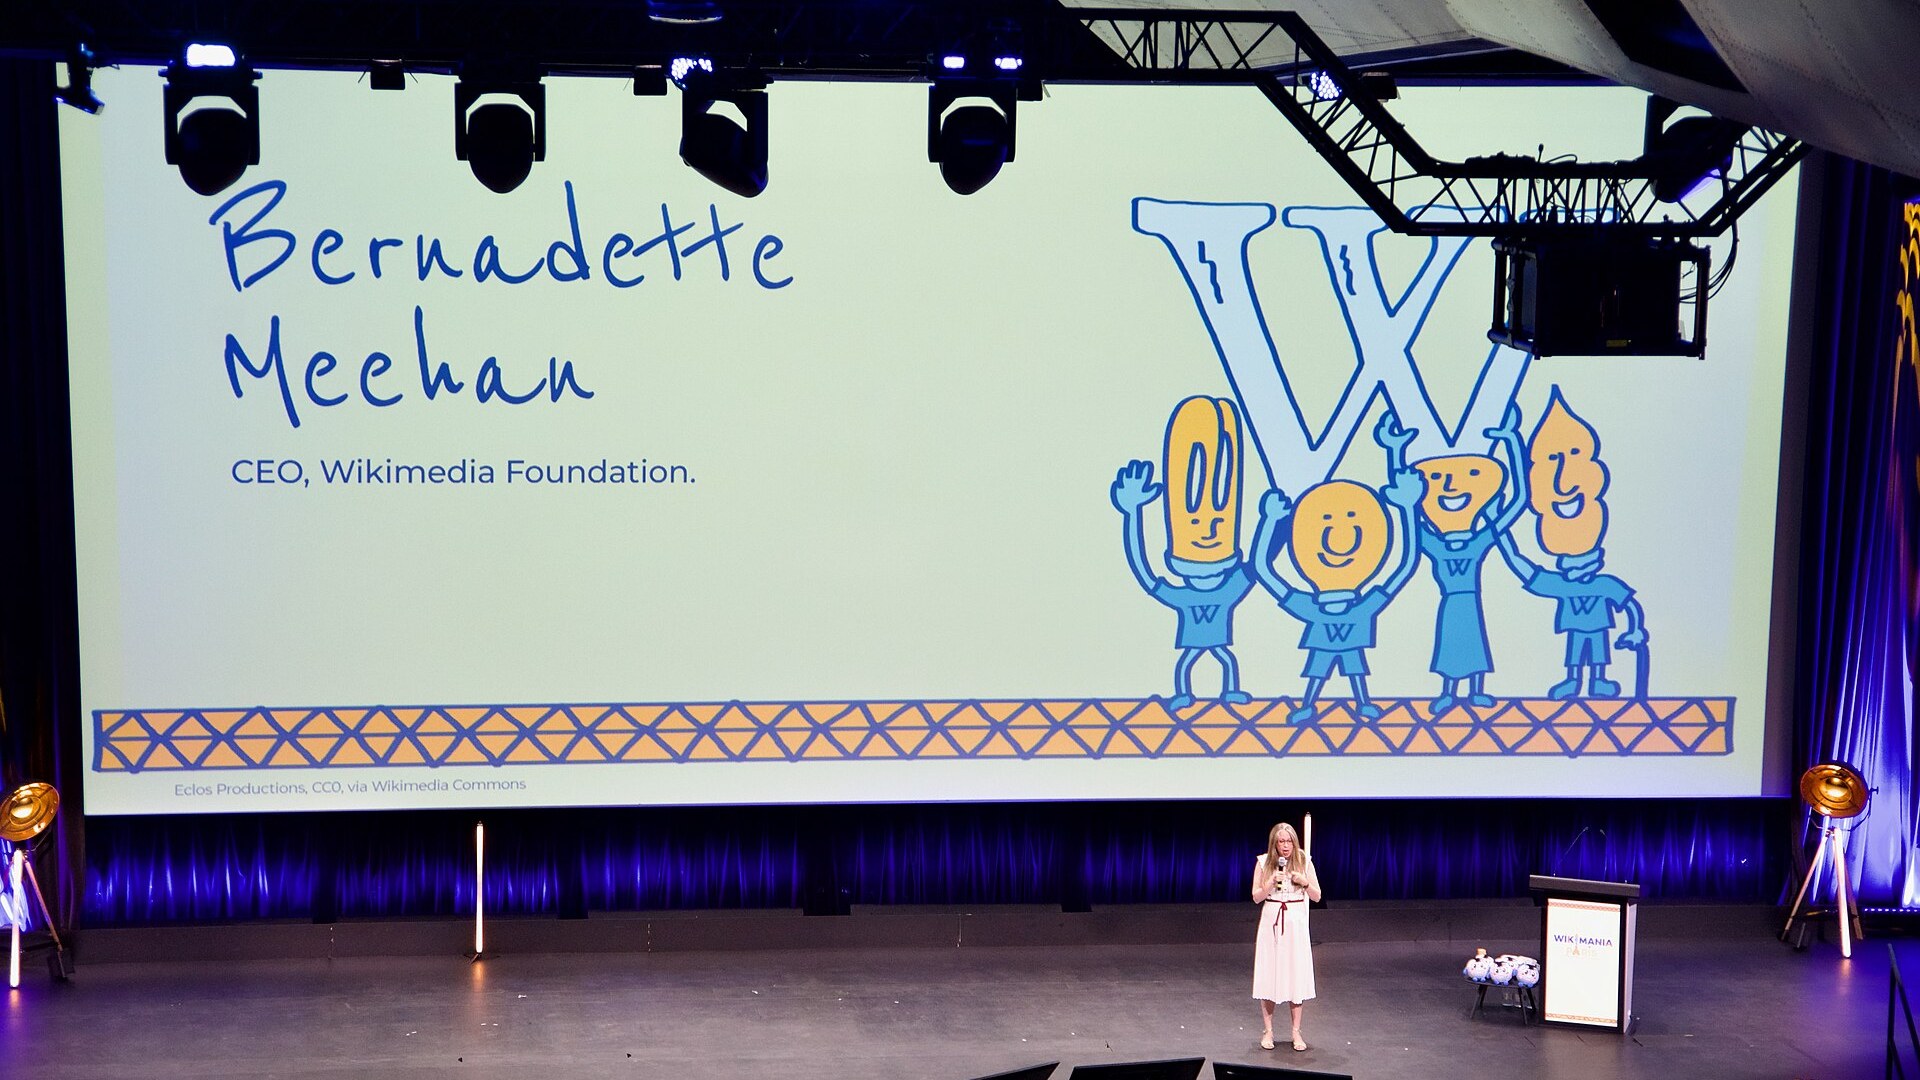
Wikimedia Foundation, organisasi nirlaba pengelola Wikipedia, mengajukan amicus brief dalam gugatan hak cipta gabungan terhadap OpenAI dan Microsoft di pengadilan federal New York. Pengumuman resminya terbit pada 30 Oktober 2026 dan menyasar perkara yang menggabungkan 12 gugatan, termasuk gugatan The New York Times. Wikimedia mengambil jalan tengah: training model AI dinilai wajar, tetapi chatbot yang menyalin konten lewat RAG harus mematuhi lisensi dan memberi kredit kepada sumbernya.
Apa Isi Amicus Brief Wikimedia dalam Gugatan NYT vs OpenAI?
Amicus brief Wikimedia meminta pengadilan menilai setiap penggunaan konten oleh perusahaan AI secara terpisah. Menurut Wikimedia Foundation (2026), training model bahasa besar yang menghasilkan sesuatu yang baru layak dianggap fair use, sedangkan penyalinan konten lewat retrieval-augmented generation (RAG) untuk menjawab pertanyaan pengguna tidak layak dianggap fair use.
Dokumen itu masuk ke perkara In re: OpenAI, Inc. Copyright Infringement Litigation di Pengadilan Distrik Amerika Serikat untuk Distrik Selatan New York. Perkara ini menggabungkan 12 gugatan terhadap OpenAI, dan yang paling dikenal adalah gugatan The New York Times terhadap Microsoft dan OpenAI yang diajukan pada 2023. Pengadilan akan memutuskan apakah pemakaian konten berhak cipta untuk membangun model bahasa besar termasuk fair use.
Menurut The Next Web, Wikimedia mengajukan permohonan izin untuk menyerahkan brief tersebut pada Kamis, 29 Oktober 2026, lalu mengumumkannya sehari kemudian. Hakim Sidney H. Stein yang menangani perkara belum memutuskan soal fair use, dan juga belum memutuskan apakah brief itu diterima. Engadget mencatat summary judgment atas perkara ini diperkirakan keluar dalam waktu dekat.
"Kami mengambil posisi dalam perkara ini untuk membela pengetahuan manusia yang bebas dan terbuka, yang menjadi sandaran Wikipedia," kata Bernadette Meehan, CEO Wikimedia Foundation. Ia menambahkan bahwa perluasan akses pengetahuan lewat AI adalah tujuan yang kuat, tetapi harus menghormati orang, kontributor, dan komunitas yang membuat pengetahuan tepercaya bisa tersedia.
Kenapa Training Model Dinilai Fair Use, tetapi RAG Tidak?
Wikimedia membedakan training dan RAG berdasarkan apa yang terjadi pada salinan konten. Saat training, model mempelajari pola dari kumpulan data besar dan hasilnya tidak menggantikan karya aslinya. Saat RAG bekerja, chatbot mengambil teks dari situs sumber lalu sering menyajikan ulang sebagian besar isinya kepada pengguna.
Dalam brief yang dikutip The Next Web, Wikimedia menulis, "While the pre-training of ChatGPT's general LLM was fair use, OpenAI's use of copies in ChatGPT's RAG feature is not fair." Artinya, pre-training model umum ChatGPT dinilai wajar, tetapi pemakaian salinan dalam fitur RAG ChatGPT dinilai tidak wajar. Wikimedia juga merujuk putusan Mahkamah Agung Amerika Serikat soal karya Warhol pada 2023 sebagai dasar penilaian per penggunaan.
Posisi ini menolak dua tafsir ekstrem sekaligus. The New York Times berpendapat pemakaian kontennya untuk tujuan apa pun, termasuk training, melanggar hak cipta. OpenAI dan Microsoft berpendapat training dan penerapan model berbasis data publik termasuk fair use. Wikimedia menyebut kedua pihak membawa tafsir fair use yang terlalu luas dan terlalu disederhanakan.
Stephen LaPorte, General Counsel Wikimedia Foundation, menjelaskan risikonya di blog Diff. Jika training tidak dianggap fair use, pengembangan AI hanya terjangkau oleh korporasi terbesar yang mampu membayar konten. Sebaliknya, hak menyeluruh bagi perusahaan AI untuk mengabaikan lisensi akan mendorong penerbit mengunci lebih banyak informasi di balik berbagai pembatasan akses.
Lisensi CC BY-SA 4.0 dan Beban Scraping di Server Wikipedia
Untuk konten Wikipedia, syarat yang diminta Wikimedia adalah kepatuhan pada lisensi Creative Commons CC BY-SA 4.0. Lisensi ini mewajibkan kredit kepada penulis asli dan mewajibkan hasil adaptasi tetap memakai lisensi yang sama. Chatbot yang memakai konten Wikipedia lewat RAG tanpa memenuhi syarat itu dinilai melanggar.
Taruhannya besar karena skala Wikipedia. Menurut Wikimedia Foundation (2026), Wikipedia memuat lebih dari 67 juta artikel dalam 300 bahasa, dan setiap bulan hampir 250.000 relawan menyumbang waktu untuk menulis serta memperbaikinya. Wikipedia juga disebut sebagai salah satu dataset berkualitas tertinggi untuk melatih model bahasa besar, sekaligus penopang mesin pencari dan asisten suara.
Wikimedia juga menyoroti beban teknis dari scraping. Menurut The Next Web, filing tersebut menyebut pengambilan konten secara masif membebani server dan memaksa Wikimedia memasang pengaman teknis yang sering diakali. Wikimedia meminta pengguna berat mematuhi batas laju API publik atau berlangganan layanan Wikimedia Enterprise, baik untuk keperluan training maupun RAG.
"Diskusi apa pun soal fair use dan hak cipta di era AI tidak boleh terbatas pada organisasi yang mencari laba, tetapi harus melibatkan pemangku kepentingan di seluruh ekosistem informasi daring," kata LaPorte. Di blog Diff, Wikimedia menegaskan tidak berpihak kepada OpenAI maupun The New York Times dalam perkara ini.
Dampaknya bagi Perusahaan AI dan Pengguna RAG di Indonesia
Jika pengadilan mengikuti argumen Wikimedia, penyedia chatbot berbasis RAG harus menyiapkan mekanisme lisensi dan atribusi sumber, sementara training model relatif lebih aman. Pemisahan ini akan memengaruhi desain produk AI di banyak negara, karena putusan dari yurisdiksi New York diperkirakan menjadi rujukan bagi pengadilan lain.
Tekanan terhadap OpenAI juga datang dari banyak arah. Menurut The Next Web, hampir 400 surat kabar lokal menggugat OpenAI dan Microsoft pada Juni 2026, lalu pada Juli The New York Times dan media lain meminta hakim menjatuhkan sanksi kepada OpenAI karena dituduh menyembunyikan bukti. Pada September, Departemen Kehakiman Amerika Serikat justru berpihak kepada OpenAI dengan menyatakan training AI termasuk fair use.
Bagi perusahaan Indonesia yang membangun chatbot, asisten internal, atau mesin pencari berbasis RAG, perkara ini memberi sinyal praktis. Sumber yang ditarik saat menjawab pertanyaan sebaiknya dicatat, diberi atribusi, dan dicek lisensinya, terutama konten berita dan konten berlisensi Creative Commons. Pemakaian data internal perusahaan sendiri jauh lebih aman dibanding menyalin konten pihak ketiga.
Di dalam negeri, aturan utamanya tetap Undang-Undang Nomor 28 Tahun 2014 tentang Hak Cipta, yang menurut JDIH BPK masih berstatus berlaku. Undang-undang ini belum mengatur training model atau RAG secara khusus, sehingga perusahaan Indonesia perlu mengikuti putusan perkara New York ini sambil menyiapkan kebijakan sumber data dan atribusi sendiri. Integrator AI lokal bisa membantu memetakan sumber data mana yang aman dipakai.
Foto sampul: Fawaz.tairou, CC BY-SA 4.0, via Wikimedia Commons
(Burung Hantu Infratek / Berbagai Sumber)
⚠️ Berita ini seluruhnya diriset, ditulis, dan dikembangkan dengan bantuan AI internal Burung Hantu Infratek.
🦉 Burung Hantu Infratek adalah software house dan system integrator yang sudah berpengalaman lebih dari 5 tahun dalam pengembangan dan implementasi generative AI pada berbagai perusahaan dan institusi.
Berita Terkait OpenAI
⚔️ New York Times Gugat Perplexity: Perang Hak Cipta AI Memanas
💸 Anthropic Bayar $1,5 Miliar Settlement Hak Cipta
🚫 17 Penerbit Manga Jepang Ancam OpenAI Sora
🛡️ Texas Gugat OpenAI dan Sam Altman; Minta ChatGPT Diblokir untuk Anak
Sumber dan Referensi
[2] Why Wikimedia Is Speaking Up in a Major AI Copyright Case - Diff
[3] Wikimedia asks court to rule AI training fair use, but not chatbot copying - The Next Web
[4] The Wikimedia Foundation weighs in on the NYT's case against OpenAI - Engadget