
Studi CLEAR Temukan Selisih Biaya Token AI antar Bahasa hingga 17 Kali
Coalition for Language Equity in AI Research (CLEAR) menemukan bahwa teks yang sama bisa membutuhkan token jauh lebih banyak bila ditulis dalam bahasa selain Inggris, sehingga biaya pemakaian AI ikut membengkak. Studi yang terbit 29 September 2026 dan diangkat Rest of World pada 26 Oktober 2026 itu mengukur 19 keluarga model pada sekitar 200 bahasa, dengan selisih terburuk mencapai 17 kali lipat. Temuan ini penting karena hampir semua penyedia model menagih per token, apa pun bahasanya.
Apa Itu Pajak Tokenizer dan Seberapa Besar Selisihnya?
Pajak tokenizer adalah biaya tambahan yang dibayar pengguna bahasa non-Inggris karena tokenizer memecah teks mereka menjadi lebih banyak token. CLEAR mengukurnya pada FLORES-200, kumpulan kalimat yang diterjemahkan profesional ke sekitar 200 bahasa, lalu membandingkan jumlah token bahasa termahal dengan bahasa termurah untuk isi yang sama.
Tokenizer adalah komponen yang memotong teks menjadi potongan kecil sebelum diproses model. Potongan itu bisa berupa kata utuh, sebagian kata, satu huruf, tanda baca, bahkan satu byte. Bahasa yang datanya melimpah di internet cenderung dipotong rapi per kata, sedangkan bahasa yang jarang muncul di data pelatihan dipotong menjadi pecahan yang jauh lebih kecil.
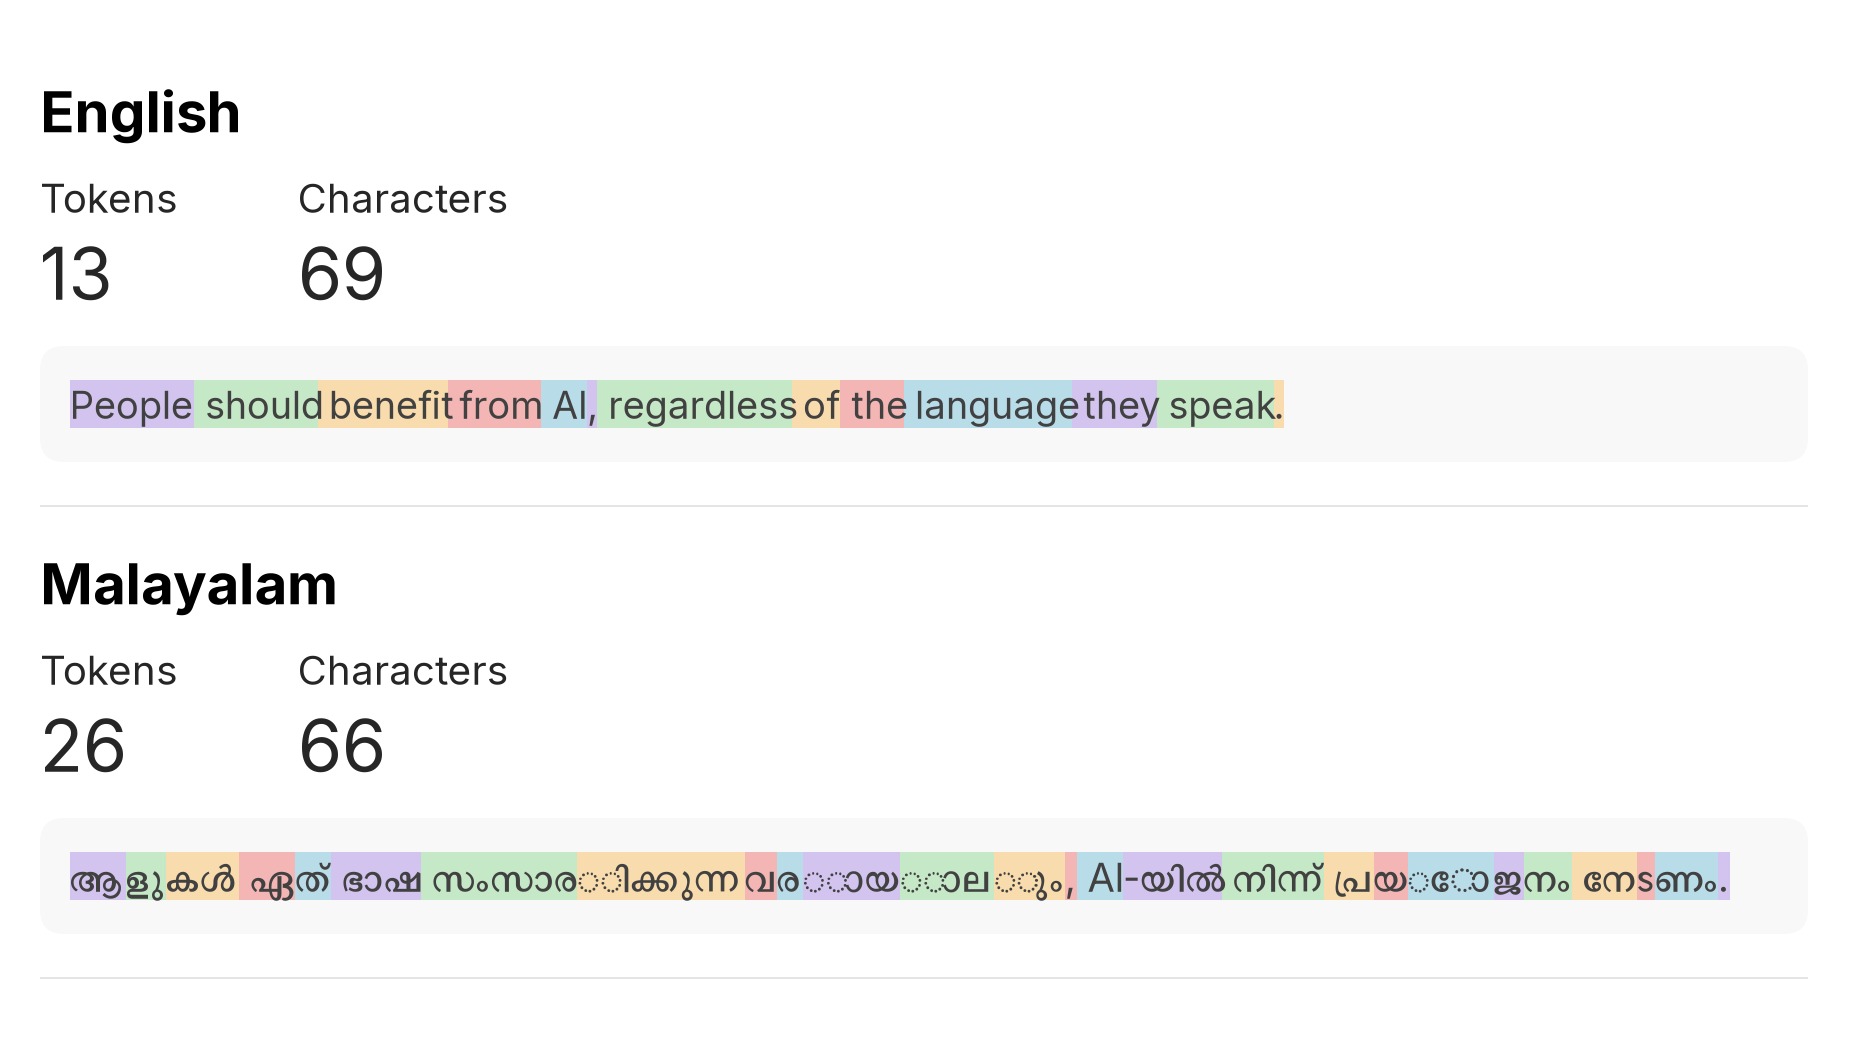
Contoh dari studi itu cukup gamblang. Kalimat Inggris "People should benefit from AI, regardless of the language they speak." butuh 13 token pada tokenizer GPT-5. Padanannya dalam bahasa Malayalam butuh 26 token, sedangkan versi Amharik butuh 78 token. Artinya, memberi input yang sama ke GPT-5 dalam bahasa Amharik enam kali lebih mahal daripada dalam bahasa Inggris.
Untuk 20 bahasa dengan kehadiran web terbesar, rasio token bahasa termahal terhadap termurah masih berkisar 1,5 sampai 3,1 kali, dengan satu pengecualian. Begitu cakupan diperluas ke seluruh bahasa FLORES-200, rentangnya melebar dari 2,7 kali pada tokenizer paling adil hingga 17 kali pada kasus terburuk. Para peneliti menyebut kesenjangan ini tidak berubah berarti sejak pertama kali didokumentasikan pada 2023.
Rapor Model AI, Tak Ada Model Frontier yang Dapat Nilai A
CLEAR memberi nilai A sampai F berdasarkan rasio token bahasa termahal terhadap termurah. Hasilnya, tidak ada model frontier serbaguna yang meraih nilai lebih baik dari B, dan sebagian besar mendapat F. Keluarga Gemini dan Gemma dari Google menjadi yang terbaik dengan rasio 5,1 kali dan nilai B.
Skala penilaiannya sederhana. Nilai A untuk rasio 3 kali atau kurang, B sampai 6 kali, C sampai 9 kali, D sampai 12 kali, dan F untuk rasio di atas 12 kali. Satu-satunya peraih A adalah NLLB-200 milik Meta dengan rasio 2,7 kali, tetapi model itu khusus penerjemahan dan tokenizernya sengaja dirancang untuk 200 bahasa sejak awal.
Di kelompok D ada Claude Fable 5 dan Opus 4.8 dari Anthropic (9,3 kali), Llama 4 Scout dari Meta (9,5 kali), Qwen 3 (10,5 kali), DeepSeek V4.1 Flash (10,6 kali), dan Kimi K3 (11,3 kali). GPT-5 dan gpt-oss dari OpenAI mendapat F dengan rasio 13,8 kali, sedangkan Falcon 3 dari TII menjadi yang terburuk dengan 17 kali.
Studi itu juga menunjukkan bahwa model baru tidak otomatis lebih adil. Qwen 3.6 dari Alibaba justru memburuk menjadi 13,1 kali dibanding Qwen 3 yang 10,5 kali. Sebaliknya, keluarga Llama membaik dari 14,8 kali pada Llama 3.3 menjadi 9,5 kali pada Llama 4. Dengan ukuran lain, GPT-5 malah unggul karena 78 persen bahasa yang diuji masih berada di bawah dua kali jumlah token bahasa termurahnya.
Aksara Jadi Penentu, Bukan Jumlah Penutur
Faktor terbesar di balik pajak tokenizer adalah aksara, bukan sedikit atau banyaknya penutur. Bahasa beraksara Latin, termasuk yang kecil seperti Asturia, mendapat potongan harga. Bahasa yang memakai aksara jarang terlihat tokenizer, seperti Myanmar, Tibet, Tifinagh, Khmer, Lao, dan Ol Chiki, menanggung beban paling berat di hampir semua model.
Beban itu tidak hanya menimpa bahasa kecil. Bila diurutkan menurut jumlah penutur, pajak ini mengenai Punjabi dengan sekitar 200 juta penutur, Bengali sekitar 266 juta, dan Urdu sekitar 288 juta. Para peneliti menegaskan selisih panjang alami antarbahasa hanya puluhan persen, misalnya bahasa Shan yang hanya 42 persen lebih panjang dari Inggris, sehingga tidak bisa menjelaskan selisih token hingga enam kali.
Dampaknya juga lebih dari sekadar tagihan. Token yang lebih banyak berarti latensi lebih tinggi dan jendela konteks yang efektif lebih sempit. "Think about a tutor: Retaining the student's earlier mistakes and explanations is part of delivering a good lesson. If that history consumes the context window much faster in one language, the disadvantage reaches into the quality of the service," kata Pratyush Choudhury, salah satu pendiri Activate AI, kepada Rest of World.
Dheemanth Reddy, CEO Maya Research, menilai harga token yang terus turun akan meredam dampak biaya secara langsung. Namun, ia mengingatkan bahwa data pelatihan yang lebih baik saja tidak cukup, karena laboratorium AI tetap harus sengaja merancang tokenizer generasi berikutnya agar menangani bahasa dan aksara ini dengan lebih baik.
Berapa Selisih Biaya untuk Bahasa Indonesia?
Bahasa Indonesia termasuk yang relatif beruntung karena memakai aksara Latin, tetapi tetap tidak gratis. Hitungan Burung Hantu Infratek atas data token FLORES-200 yang dibuka CLEAR di GitHub menunjukkan teks berbahasa Indonesia butuh 8 sampai 62 persen lebih banyak token daripada padanan Inggrisnya pada delapan model populer yang dihitung.
Pada data itu, selisih terkecil ada di Qwen 3.6 (8 persen), Llama 4 Scout (13 persen), dan Gemini 3.8 Flash (14 persen). GPT-5 berada di 24 persen dan DeepSeek V4.1 Flash di 34 persen. Selisih terbesar ada di GLM-5.3 (54 persen), Kimi K3 (58 persen), dan Claude Fable 5 (62 persen). Bahasa Jawa dan Sunda lebih mahal lagi, umumnya 37 sampai 83 persen di atas bahasa Inggris pada model yang sama.
Sebagai ilustrasi, CLEAR mencatat harga input Claude Fable 5 sebesar 10 dolar AS per satu juta token. Beban kerja yang setara 100 juta token dalam bahasa Inggris berarti sekitar 1.000 dolar AS, sementara isi yang sama dalam bahasa Indonesia bisa menjadi sekitar 1.620 dolar AS. Selisih itu belum menghitung token output, yang harganya 50 dolar AS per satu juta token.
CLEAR meminta laboratorium AI mencantumkan rasio token antarbahasa di model card dan menerapkan harga yang dinormalisasi per karakter atau per bahasa. Studi itu juga menyarankan pembeli sektor publik mewajibkan pengungkapan biaya tokenisasi multibahasa dalam kontrak pengadaan sistem AI, sekaligus menetapkan nilai minimum kesetaraan token sebagai syarat kualifikasi.
Bagi perusahaan dan instansi pemerintah di Indonesia, temuan ini berarti perbandingan harga model tidak cukup dilakukan dari tarif per juta token di halaman harga. Uji dulu jumlah token dari dokumen, percakapan, dan prompt berbahasa Indonesia yang sebenarnya, apalagi bila layanan juga melayani bahasa daerah. Model yang tarifnya tampak murah bisa berakhir lebih mahal setelah selisih token dihitung.
(Burung Hantu Infratek / Berbagai Sumber)
⚠️ Berita ini seluruhnya diriset, ditulis, dan dikembangkan dengan bantuan AI internal Burung Hantu Infratek.
🦉 Burung Hantu Infratek adalah software house dan system integrator yang sudah berpengalaman lebih dari 5 tahun dalam pengembangan dan implementasi generative AI pada berbagai perusahaan dan institusi.
Berita Terkait Biaya Token AI
💸 Menghitung Biaya AI untuk Perusahaan: Token, Harga Model, dan Cara Hemat
📊 OpenAI Minta Enterprise Stop Hitung Token AI
📉 ITU Peringatkan Kesenjangan AI Bisa Jadi Kesenjangan Peluang
⚡ MiniMax Rilis M3.1 Flash; Harga $0,15 per Juta Token Input
Sumber dan Referensi
[2] AI models cost more when you don't use English - Rest of World
[3] clear-coalition-ai/token-cost-equity - GitHub
[4] Language Model Tokenizers Introduce Unfairness Between Languages - arXiv