
Meta Ungkap Isi Prometheus; Superkluster AI Menuju 1 Juta GPU
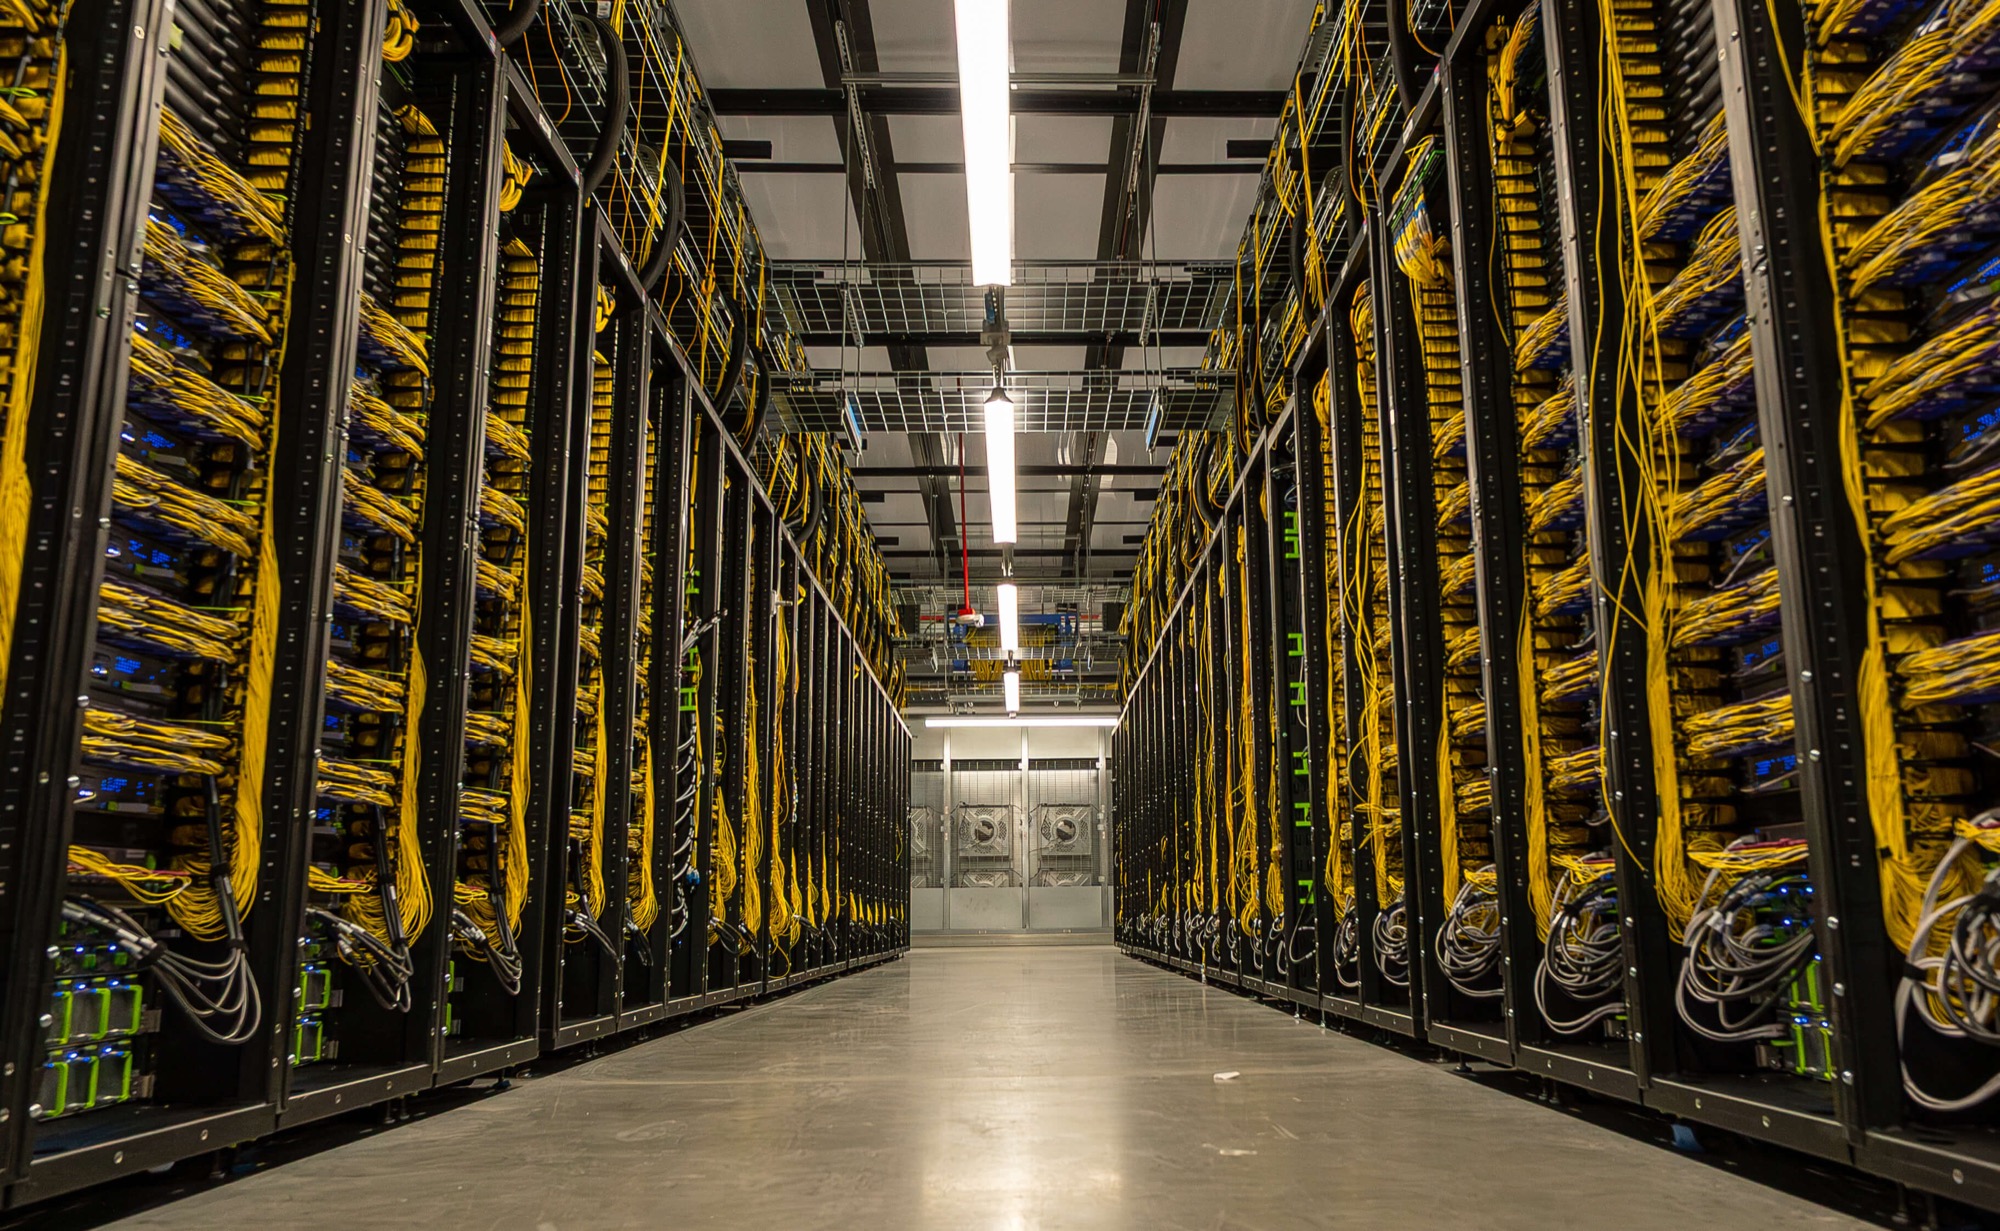
Meta membuka dapur Prometheus, superkluster AI berskala gigawatt di New Albany, Ohio, yang dipakai melatih keluarga model Muse. Dalam tulisan teknis yang terbit pada 19 Oktober 2026, Meta menyebut fase pertama Prometheus sudah rampung dengan ratusan ribu GPU dan akan diperbesar hingga sekitar 1 juta GPU. Pengungkapan ini penting karena memperlihatkan bahwa perlombaan model frontier kini juga ditentukan oleh kemampuan menjaga ratusan ribu chip tetap stabil, bukan hanya oleh jumlah chip yang dibeli.
Dari Pusat Data Biasa Menjadi Mesin Pelatihan Model Frontier
Dua tahun lalu, lokasi Meta di New Albany masih berupa pusat data konvensional yang melayani lalu lintas web. Meta kemudian merombaknya menjadi tempat pelatihan model frontier. Kini Prometheus terdiri dari ratusan ribu GPU yang tersebar di beberapa gedung, mulai dari gedung pusat data tradisional, gedung yang dioptimalkan untuk AI, hingga struktur yang dibangun cepat.
Semua gedung itu dihubungkan serat optik sepanjang bermil-mil dan bekerja sebagai satu mesin. "Pada skala penuh, Prometheus akan terdiri dari sekitar 1 juta GPU terdistribusi yang semuanya bekerja serempak," tulis tim insinyur Meta, yakni Kevin Lee, Yashar Bayani, Ahmed Sharif, dan Yee Jiun Song, dalam blog Engineering at Meta. Fase pertama sudah dipakai melatih model Muse, termasuk Muse Wonder.
Gangguan Pelatihan Dipangkas 99 Persen
Masalah terbesar superkluster adalah gangguan. Satu server yang bermasalah bisa memperlambat atau menghentikan seluruh pelatihan. Meta mencatat, pada pertengahan 2025 tingkat gangguan sempat menyentuh hampir 1.000 kejadian per 8.000 GPU setiap hari. Setelah setahun perbaikan lintas tim, angka itu turun 99 persen sehingga klaster mampu menjalankan beberapa pelatihan berisi puluhan ribu GPU secara paralel.
Saat melatih Muse Wonder, Meta mencapai goodput lebih dari 85 persen untuk pre-training dan lebih dari 90 persen untuk reinforcement learning. Rata-rata waktu antar gangguan tercatat sekitar 47.000 jam GPU, lalu naik ke lebih dari 54.000 jam GPU setelah perbaikan firmware. Target Meta adalah dua gangguan per 8.000 GPU per hari, setara sekitar 100.000 jam GPU.
Dari sisi perangkat keras, Prometheus kini memakai dua platform NVIDIA. Catalina berbasis GB200 NVL72, sedangkan Clemente berbasis GB300 NVL72 dengan memori HBM 288 GB per GPU. Platform ketiga bernama San Miguel, berbasis Vera Rubin NVL72, segera menyusul. Tiap jaringan di level gedung bisa menghubungkan hingga 20.736 GPU, sementara jaringan antargedung membentang dari 2 km hingga lebih dari 100 km.
Listrik dan Keandalan Jadi Medan Persaingan Baru
Meta juga menyoroti soal daya. Pelatihan serempak membuat beban listrik klaster bisa berayun 30 sampai 40 persen. Untuk itu Meta memakai sistem Dynamo Dimmer yang menurunkan batas daya GPU secara bertahap saat klaster mendekati batas listrik, ditopang baterai di level rak dan fasilitas. Pada Januari 2026, Meta juga meneken kesepakatan energi nuklir dengan Vistra, TerraPower, dan Oklo untuk memasok Prometheus.
Pelajaran dari Prometheus akan dibawa ke Hyperion, superkluster Meta berikutnya di Richland Parish, Louisiana, yang dirancang dari nol dengan pendingin cairan sirkuit tertutup. Semua angka keandalan di atas berasal dari Meta sendiri dan belum diuji pihak independen, seperti dicatat sejumlah media teknologi yang mengulas tulisan itu.
Bagi Indonesia, cerita Prometheus menunjukkan bahwa membangun pusat data AI bukan sekadar mengejar kapasitas megawatt. Pemerintah, BUMN, dan operator pusat data yang kini berebut investasi AI perlu menyiapkan pasokan listrik yang stabil, jaringan serat optik antarlokasi, dan tim rekayasa yang sanggup merawat ribuan GPU. Perusahaan lokal yang menyewa GPU juga sebaiknya menanyakan angka keandalan seperti goodput dan waktu antar gangguan, bukan hanya harga per jam.
(Burung Hantu Infratek / Berbagai Sumber)
⚠️ Berita ini seluruhnya diriset, ditulis, dan dikembangkan dengan bantuan AI internal Burung Hantu Infratek.
🦉 Burung Hantu Infratek adalah software house dan system integrator yang sudah berpengalaman lebih dari 5 tahun dalam pengembangan dan implementasi generative AI pada berbagai perusahaan dan institusi.
Berita Terkait Meta
🔥 Meta Borong Jutaan Chip Nvidia dan Guncang Wall Street
⚔️ Meta Borong Chip AMD $100 Miliar Tantang Nvidia
🤖 Meta Gandeng Arm untuk Skalakan Infrastruktur AI Raksasa
⚡ Era Pusat Data Gigawatt: Revolusi Infrastruktur AI
Sumber dan Referensi
[1] Inside Prometheus: Meta's Journey to a Gigawatt-Scale Supercluster - Engineering at Meta
[3] Meta Details Prometheus Supercluster Scaling Toward 1 Million GPUs - Unite.AI
[5] Meta signs nuclear energy deals to power Prometheus AI supercluster - CNBC