
Baidu Buka Unlimited OCR 2; Model 3B Baca Ratusan Halaman Sekali Jalan
Baidu merilis Unlimited OCR 2, model pembaca dokumen open source berukuran 3 miliar parameter yang mampu mengurai dokumen ratusan halaman dalam satu kali proses. Model ini diumumkan pada 27 Oktober 2026 dengan lisensi MIT dan meraih skor 77,06 pada benchmark MarathonDocBench, lebih dari dua kali skor model pembanding terbaik. Rilis ini penting karena digitalisasi kontrak, laporan tahunan, dan arsip tebal selama ini tersendat oleh biaya komputasi yang membengkak seiring jumlah halaman.
Apa Itu Unlimited OCR 2 dari Baidu?
Unlimited OCR 2 adalah model vision-language dari tim ERNIE Baidu yang mengubah gambar halaman dokumen menjadi teks terstruktur, termasuk tabel, rumus, gambar, judul bagian, dan urutan baca. Bedanya dengan OCR biasa, model ini membaca puluhan sampai ratusan halaman sekaligus dalam satu permintaan, bukan halaman per halaman.
Model ini diumumkan lewat akun resmi Baidu Inc. di X pada 27 Oktober 2026 dan bobotnya langsung dibuka di Hugging Face, GitHub, ModelScope, serta Baidu Cloud. Lisensinya MIT, sehingga perusahaan boleh memakai, memodifikasi, dan menjalankannya di server sendiri, termasuk untuk produk komersial, tanpa membayar biaya lisensi kepada Baidu.
Menurut laporan teknis Baidu, arsitekturnya memakai DeepEncoder dari DeepSeek OCR yang dipasangkan dengan decoder Mixture-of-Experts. Total parameternya 3 miliar, tetapi hanya sekitar 500 juta parameter yang aktif untuk tiap token. Ukuran ini tergolong kecil untuk model yang dibandingkan langsung dengan Gemini, Qwen, dan Kimi dalam tugas membaca dokumen.
Versi ini adalah penerus Unlimited OCR generasi pertama yang dirilis Baidu pada 22 Juni 2026. Versi pertama hanya sanggup menangani dokumen hingga sekitar 40 halaman, sehingga tidak bisa diuji pada benchmark ratusan halaman. Lompatan dari puluhan ke ratusan halaman inilah yang disebut Baidu sebagai awal era yang mereka namai OCR 3.0.
Bagaimana Model Ini Menekan Biaya Komputasi Dokumen Panjang?
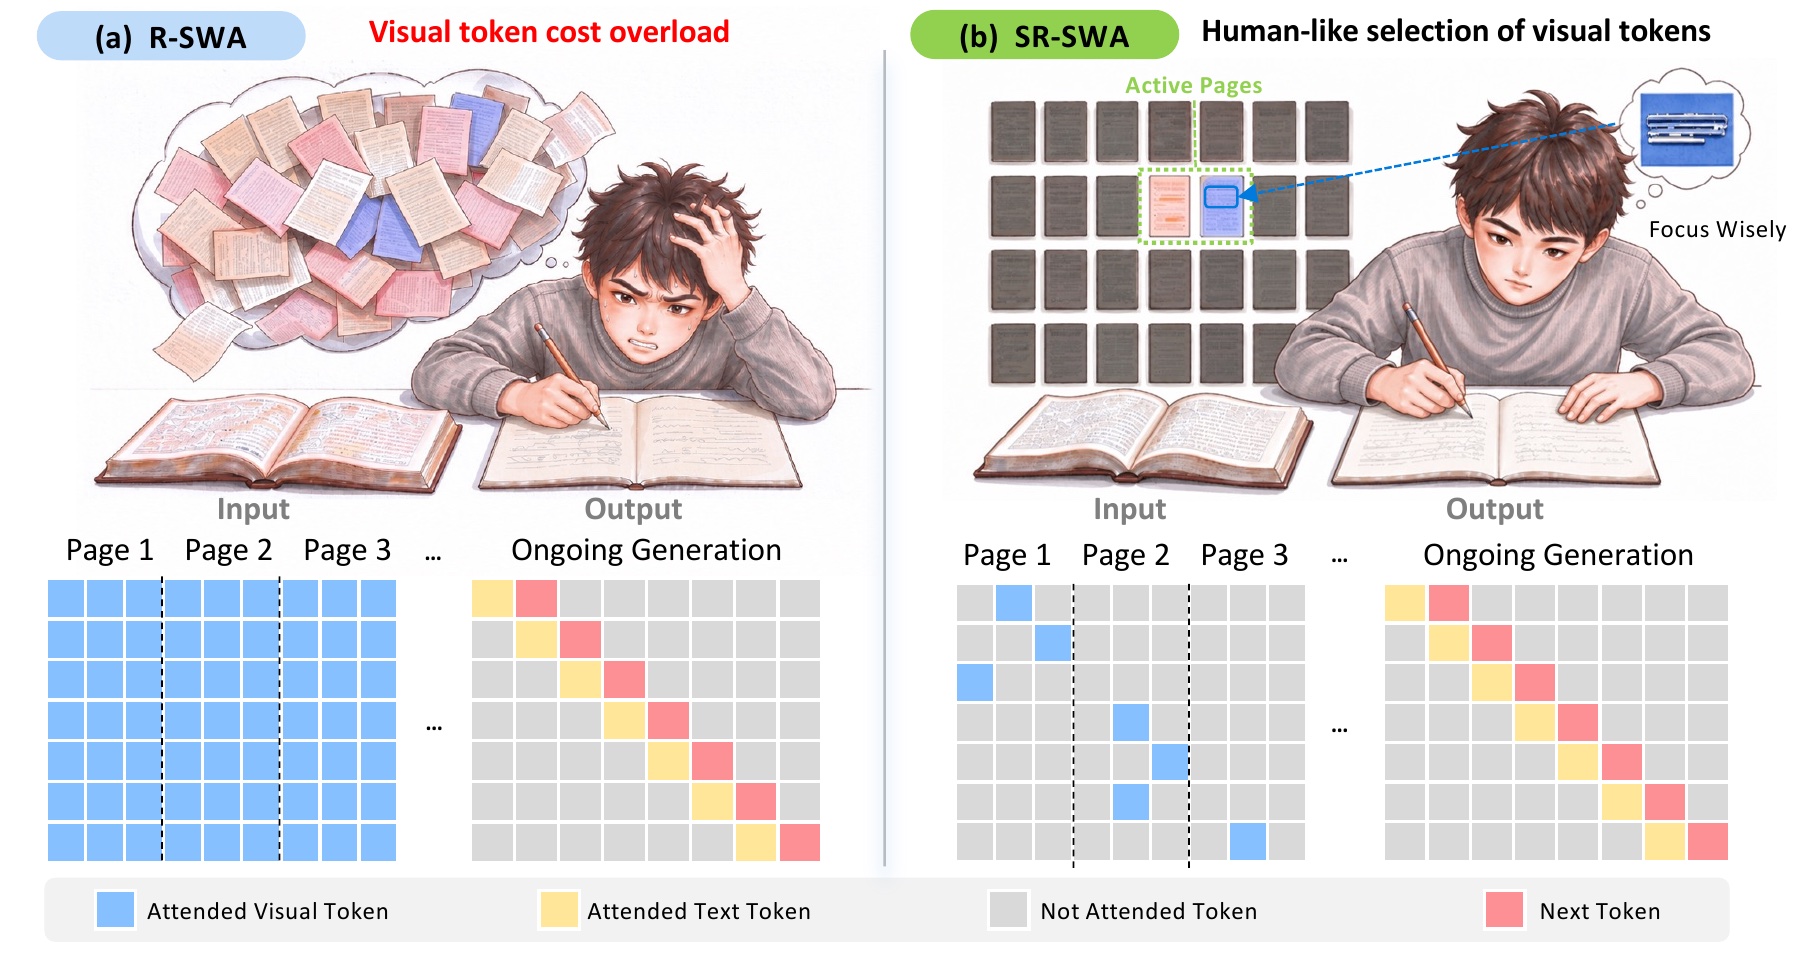
Kuncinya adalah mekanisme Sparse Reference Sliding Window Attention (SR-SWA). Alih-alih memperhatikan semua halaman setiap kali menulis kata berikutnya, model hanya melihat sekumpulan kecil referensi visual yang relevan, misalnya 512 token. Akibatnya, waktu dan memori per langkah decoding nyaris tetap, berapa pun tebal dokumennya.
Tim ERNIE Baidu menggambarkan cara kerja ini dengan analogi orang yang menyalin buku tebal. "Kami memperkenalkan Unlimited OCR 2, model parsing dokumen yang hanya melihat apa yang sedang ia transkripsikan," tulis tim ERNIE Baidu dalam laporan teknisnya. Penyalin manusia fokus ke halaman yang sedang dikerjakan dan hanya sesekali menengok halaman sebelumnya saat ada rujukan lintas halaman.
Pada model biasa, beban attention tumbuh kuadratik terhadap panjang teks. Dokumen 200 halaman bisa menghabiskan memori GPU jauh sebelum selesai dibaca. Menurut laporan teknis Baidu (Oktober 2026), pada skala ratusan halaman SR-SWA mempercepat tiap langkah decoding 7,0 kali dibanding full attention dan 5,6 kali dibanding R-SWA, mekanisme yang dipakai versi pertama.
Pelatihannya juga terbilang hemat. Baidu melanjutkan dari checkpoint versi pertama dan melatih satu epoch di klaster 25 node berisi masing-masing 8 GPU NVIDIA H800. Korpus pelatihannya terdiri dari 2 juta dokumen multi-halaman dan 10 juta dokumen satu halaman, dengan label awal diambil dari MinerU2.5-Pro dan PaddleOCR-VL.
Skor MarathonDocBench Jauh di Atas Gemini dan Qwen
Pada MarathonDocBench, benchmark baru buatan Baidu berisi 100 dokumen setebal 103 sampai 300 halaman, Unlimited OCR 2 mencetak skor keseluruhan 77,06. Pesaing terdekat, Kimi-K3, hanya meraih 33,74. Gemini-3.8-Flash mendapat 28,61, Gemini-3.1-Pro Preview 26,97, dan Qwen3.8-Max 22,93.
MarathonDocBench memuat 205 ribu elemen tata letak yang dianotasi, termasuk teks dan tabel yang bersambung ke halaman berikutnya. Bagian lintas halaman inilah yang paling sering membuat model umum gagal, karena struktur tabel atau paragraf terputus di tengah jalan. Model yang kehilangan konteks akan menghasilkan tabel pecah atau urutan baca yang kacau.
Pada MPDocBench, benchmark lain untuk dokumen hingga 30 halaman, Unlimited OCR 2 meraih 84,59. Angka ini di atas Qwen3.8-Max (78,30), Qwen-3.8-Flash-Next (77,36), dan Gemini-3.8-Flash (76,25). Menurut Baidu, keunggulannya mencapai 6,3 poin di MPDocBench dan 43,3 poin di MarathonDocBench dibanding model terbaik berikutnya.
Perlu dicatat, semua angka tersebut berasal dari pengujian Baidu sendiri, dan MarathonDocBench juga disusun oleh Baidu. Laporan teknisnya pun mengakui keterbatasan, yaitu data pelatihan yang belum cukup beragam dan mekanisme sparse attention yang belum menyimpan informasi global dokumen, sehingga pemahaman hierarki judul masih lemah. Uji independen belum tersedia.
Apa Dampaknya bagi Perusahaan di Indonesia?
Bagi perusahaan Indonesia, Unlimited OCR 2 membuka jalan mendigitalkan dokumen tebal seperti kontrak, laporan tahunan, dokumen tender, dan arsip instansi dengan model yang bisa dijalankan di server sendiri. Lisensi MIT dan ukuran 3 miliar parameter membuatnya cukup dijalankan pada satu GPU, tanpa mengirim dokumen ke layanan cloud luar negeri.
Baidu menguji model ini pada satu GPU NVIDIA A800 80 GB dan menyediakan resep serving untuk SGLang. Menurut AlphaSignal, bobotnya dalam format BF16 hanya sekitar 6 GB sebelum memperhitungkan cache dan permintaan paralel. Artinya, tim TI menengah pun bisa mencobanya tanpa investasi pusat data besar, walau beban produksi tetap butuh perhitungan kapasitas.
Meski begitu, Baidu tidak merinci performa model untuk dokumen berbahasa Indonesia, dan kartu modelnya hanya menyebut dukungan multibahasa. Bagi perusahaan, pengembang, dan instansi di Indonesia, langkah aman adalah menguji dulu dengan sampel dokumen sendiri, seperti faktur, akta, atau laporan keuangan, lalu membandingkan hasilnya dengan OCR yang sudah dipakai sebelum memindahkan alur kerja inti.
(Burung Hantu Infratek / Berbagai Sumber)
⚠️ Berita ini seluruhnya diriset, ditulis, dan dikembangkan dengan bantuan AI internal Burung Hantu Infratek.
🦉 Burung Hantu Infratek adalah software house dan system integrator yang sudah berpengalaman lebih dari 5 tahun dalam pengembangan dan implementasi generative AI pada berbagai perusahaan dan institusi.
Berita Terkait AI China
🛡️ Cohere Temukan Model Qwen Alibaba Coba Unggah File ke Server Beijing
🚀 DeepSeek Rilis V4.1-Flash-1017; Buka Search API untuk Agen AI
⚡ Bug KV Cache Cloudflare Bocorkan 155 Respons GLM-5.3 ke Pelanggan Lain
📊 Studi CLEAR Temukan Selisih Biaya Token AI antar Bahasa hingga 17 Kali
Sumber dan Referensi
[1] baidu/Unlimited-OCR-2 - Hugging Face
[2] Unlimited OCR Works 2: Pioneering the OCR-3.0 Era - Baidu ERNIE Team
[3] baidu/Unlimited-OCR - GitHub
[4] MarathonDocBench - Hugging Face
[5] Unlimited OCR Works - arXiv
[6] Baidu Open-Sources Unlimited OCR 2 to Parse Hundreds of Pages Without Breaking - AlphaSignal