
RAG atau Fine-Tuning: Cara Memilih Kustomisasi AI Setelah OpenAI Batasi Fine-Tuning
Retrieval-augmented generation (RAG) dan fine-tuning adalah dua cara paling populer untuk membuat model AI generatif paham urusan perusahaan Anda. Sederhananya, RAG memberi model "buku contekan" berisi dokumen perusahaan setiap kali ia menjawab, sedangkan fine-tuning melatih ulang model sampai kebiasaan tertentu tertanam di dalamnya. Tulisan ini membahas perbedaan keduanya, perubahan layanan fine-tuning OpenAI sepanjang 2026, data pemakaian di perusahaan, kapan memilih masing-masing teknik, perbandingan biaya, risiko keamanan, kewajiban UU PDP, hingga langkah memilih yang praktis.
TLDR
Apa Bedanya RAG dan Fine-Tuning?
RAG mengambil dokumen yang relevan lalu menyisipkannya ke prompt, sedangkan fine-tuning mengubah bobot model lewat pelatihan dengan contoh berlabel.
Apa yang Berubah pada Fine-Tuning OpenAI Tahun 2026?
Sejak 7 Mei 2026 OpenAI menutup pembuatan job fine-tuning bagi organisasi baru, dan pelanggan aktif tidak bisa membuat job baru mulai 6 Januari 2027.
Teknik Kustomisasi Mana yang Paling Banyak Dipakai Perusahaan?
Laporan Menlo Ventures Desember 2025 mencatat prompt design paling dominan, disusul RAG, sementara fine-tuning masih dipakai segelintir tim.
Kapan RAG Menjadi Pilihan yang Tepat?
RAG cocok untuk pengetahuan yang sering berubah, perlu sumber yang bisa ditelusuri, dan punya hak akses berbeda untuk tiap pengguna.
Kapan Fine-Tuning Masih Layak Dipakai?
Fine-tuning layak untuk tugas sempit yang berulang dengan data berlabel, seperti klasifikasi, format keluaran baku, atau gaya bahasa yang konsisten.
Berapa Biaya dan Usaha Perawatan Masing-Masing?
RAG menuntut biaya pengindeksan dan token konteks, fine-tuning menuntut biaya data berlabel, pelatihan ulang, dan migrasi saat model dasar pensiun.
Apa Risiko Keamanan RAG Menurut OWASP?
OWASP memasukkan kelemahan vektor dan embedding ke daftar risiko LLM 2025, mulai dari kebocoran akses sampai peracunan data.
Bagaimana UU PDP Memengaruhi Pilihan RAG atau Fine-Tuning?
Hak hapus data di UU PDP lebih mudah dipenuhi lewat RAG, karena data pribadi yang sudah masuk bobot model sulit dicabut.
Langkah Memilih Kustomisasi AI untuk Perusahaan Indonesia
Mulai dari evaluasi dan prompt, tambahkan RAG untuk pengetahuan, lalu pertimbangkan fine-tuning hanya untuk tugas yang terbukti tidak terselesaikan.
Kesimpulan
Untuk sebagian besar perusahaan, RAG yang dirancang aman adalah fondasi, sedangkan fine-tuning menjadi alat khusus yang dipakai dengan sengaja.
Banyak perusahaan di Indonesia sudah mencoba ChatGPT, Gemini, atau Claude, lalu kecewa ketika chatbot internal mereka tidak tahu harga produk terbaru, salah menyebut prosedur klaim, atau menjawab dengan gaya yang tidak sesuai merek. Pertanyaan berikutnya hampir selalu sama: apakah model perlu dilatih ulang dengan data kita, atau cukup dihubungkan ke dokumen perusahaan? Pertanyaan itu makin mendesak pada 2026, karena salah satu penyedia terbesar mengubah layanan fine-tuning-nya. Artikel ini membantu tim bisnis dan TI menjawabnya dengan data, bukan tebakan.
Apa Bedanya RAG dan Fine-Tuning?
RAG dan fine-tuning sama-sama menyesuaikan model AI dengan kebutuhan perusahaan, tetapi caranya berbeda. RAG mencari potongan dokumen yang relevan saat pertanyaan masuk, lalu menyisipkannya ke prompt. Fine-tuning melatih model dengan ratusan sampai ribuan contoh berlabel sehingga bobot model berubah. RAG menambah pengetahuan, fine-tuning membentuk perilaku.
Istilah RAG berasal dari makalah "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" yang diunggah ke arXiv pada 22 Mei 2020 oleh Patrick Lewis bersama 11 penulis lain. Makalah itu menggabungkan dua jenis memori: memori parametrik yang tersimpan di bobot model, dan memori non-parametrik berupa indeks dokumen yang bisa dicari. Gagasan dasarnya bertahan sampai sekarang, walau implementasinya sudah jauh berkembang.
Dalam praktik modern, Anthropic (2024) menjelaskan alur RAG dalam tiga tahap persiapan. Pertama, kumpulan dokumen dipecah menjadi potongan kecil yang biasanya tidak lebih dari beberapa ratus token. Kedua, setiap potongan diubah menjadi vektor embedding yang mewakili maknanya. Ketiga, vektor itu disimpan di vector database yang bisa dicari berdasarkan kemiripan makna. Saat pengguna bertanya, sistem mengambil potongan yang paling mirip dan menambahkannya ke prompt sebelum dikirim ke model.
Fine-tuning bekerja di tempat lain. Google Cloud menjelaskan bahwa supervised fine-tuning mengadaptasi perilaku model dengan dataset berlabel, dan proses itu menyesuaikan bobot model agar selisih antara prediksi dan label sekecil mungkin. Hasilnya adalah versi model baru yang lebih fasih mengerjakan tugas tertentu, misalnya klasifikasi tiket, ringkasan laporan, atau tanya jawab ekstraktif.
Analogi yang sering dipakai adalah karyawan baru. RAG seperti memberi karyawan itu akses ke lemari arsip dan SOP terbaru, sehingga ia bisa membuka dokumen setiap kali ditanya. Fine-tuning seperti mengirimnya ke pelatihan intensif sampai cara kerjanya berubah, tetapi isi pelatihan itu tidak otomatis diperbarui ketika SOP berganti. Keduanya berguna, dan keduanya punya ongkos yang berbeda.
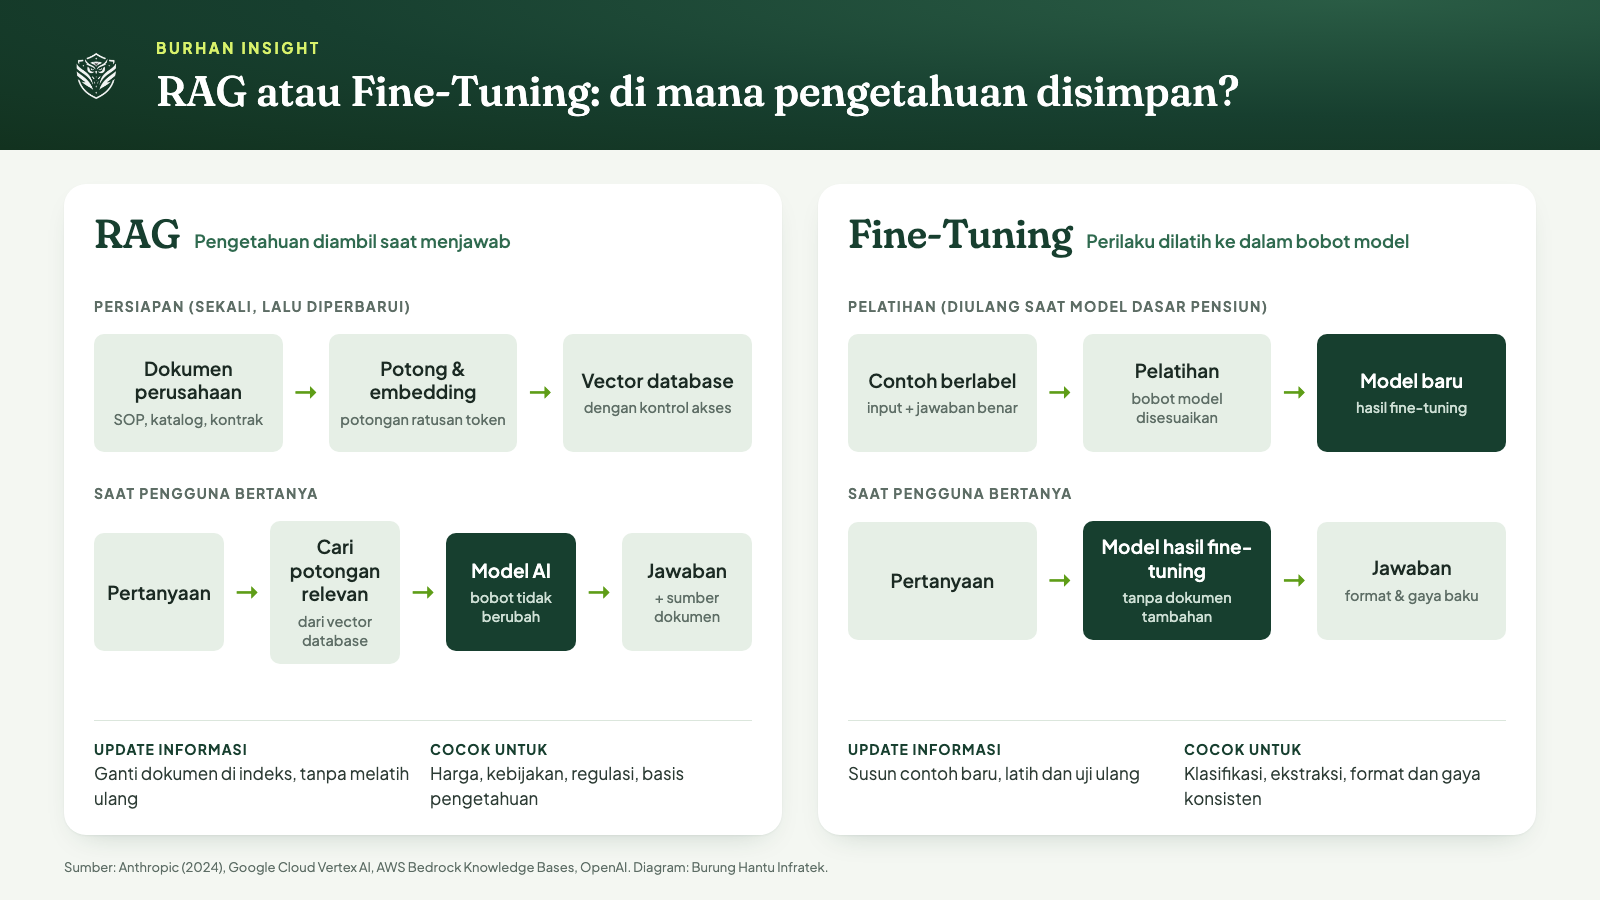
Diagram alur RAG dan fine-tuning. Diolah Burung Hantu Infratek dari dokumentasi Anthropic, Google Cloud, AWS, dan OpenAI.
Perbedaan ini penting karena banyak proyek gagal akibat salah memilih alat. Perusahaan yang ingin chatbot tahu daftar harga terbaru sering langsung berpikir tentang fine-tuning, padahal daftar harga berubah setiap bulan. Sebaliknya, perusahaan yang ingin keluaran selalu berformat JSON tertentu kadang menumpuk dokumen ke RAG, padahal masalahnya ada di perilaku model, bukan di pengetahuannya.
Ada juga jalur ketiga yang sering terlupakan, yaitu prompt yang dirancang dengan baik. Instruksi yang jelas, contoh jawaban, dan konteks singkat yang ditulis langsung di prompt kadang sudah cukup untuk kebutuhan sederhana, misalnya menjawab pertanyaan seputar jam operasional atau alamat cabang. Jalur ini paling murah dan paling cepat diuji, sehingga layak dicoba sebelum memutuskan membangun RAG atau melatih model.
Apa yang Berubah pada Fine-Tuning OpenAI Tahun 2026?
OpenAI membatasi layanan fine-tuning mandiri secara bertahap sepanjang 2026. Menurut halaman deprecations OpenAI, sejak 7 Mei 2026 organisasi yang belum pernah menjalankan fine-tuning tidak bisa membuat job pelatihan. Mulai 6 Januari 2027, pelanggan aktif pun tidak bisa membuat job fine-tuning baru, walau inferensi model hasil fine-tuning tetap berjalan.
Jadwalnya terdiri atas tiga tanggal. Pada 7 Mei 2026, OpenAI memberi tahu pengembang bahwa pembuatan job fine-tuning tidak lagi tersedia bagi organisasi yang belum pernah menjalankan fine-tuning. Pada 2 Juli 2026, pembuatan job juga ditutup bagi organisasi yang tidak menjalankan inferensi pada model hasil fine-tuning dalam 60 hari terakhir. Pada 6 Januari 2027, pelanggan aktif yang tersisa tidak bisa lagi membuat job fine-tuning baru.
Model yang sudah dilatih tidak langsung mati. OpenAI menulis bahwa inferensi pada model hasil fine-tuning tetap tersedia sampai model dasarnya dihentikan. Masalahnya, model dasar juga punya umur. Pada 14 Oktober 2026, OpenAI mengumumkan bahwa GPT-4o, GPT-4o mini, GPT-4.1, dan GPT-4.1 mini akan dihapus dari API pada 14 Januari 2027, dan versi fine-tuned dari model-model itu mengikuti jadwal penghentian yang sama.
Perubahan juga menyentuh alat evaluasi. Halaman yang sama mencatat platform Evals OpenAI diumumkan berhenti pada 3 Juni 2026, evaluasi yang ada menjadi hanya-baca pada 31 Oktober 2026, dan dashboard serta API Evals dijadwalkan tutup pada 30 November 2026. OpenAI mengarahkan pengguna ke Promptfoo sebagai jalur migrasi. Panduan model optimization OpenAI sendiri kini menyebut bahwa alur evals dan fine-tuning sedang dipindahkan ke dokumentasi lama.
Bagi perusahaan di Indonesia, perubahan ini punya tiga konsekuensi praktis. Pertama, tim yang baru mulai tidak bisa lagi memilih fine-tuning di platform OpenAI. Kedua, perusahaan yang sudah memakai model GPT-4o hasil fine-tuning harus menyiapkan migrasi sebelum 14 Januari 2027. Ketiga, strategi kustomisasi yang bergantung pada satu penyedia terbukti rapuh, sehingga data pelatihan dan set evaluasi perlu disimpan dalam format yang bisa dibawa ke platform lain.
Fine-tuning sendiri tidak hilang dari pasar. Google Cloud masih menyediakan supervised fine-tuning untuk keluarga Gemini, termasuk Gemini 3.5 Flash dan Gemini 3.5 Flash-Lite, dan model open-weight tetap bisa dilatih di infrastruktur sendiri. Namun, langkah OpenAI memberi sinyal jelas bahwa penyedia model besar kini mendorong pelanggan untuk lebih dulu memaksimalkan prompt, konteks, dan alat sebelum mengubah bobot model.
Teknik Kustomisasi Mana yang Paling Banyak Dipakai Perusahaan?
Menurut laporan "2025: The State of Generative AI in the Enterprise" dari Menlo Ventures yang terbit 9 Desember 2025, prompt design adalah teknik kustomisasi paling dominan, disusul RAG. Fine-tuning, tool calling, context engineering, dan reinforcement learning disebut masih ceruk dan terutama dipakai oleh tim-tim terdepan.
Laporan yang sama menggambarkan skala pasar yang sedang tumbuh cepat. Menlo Ventures (2025) memperkirakan belanja perusahaan untuk AI generatif mencapai 37 miliar dolar AS pada 2025, naik dari 11,5 miliar dolar AS pada 2024, atau 3,2 kali lipat dalam setahun. Lapisan aplikasi menyerap 19 miliar dolar AS, lebih dari separuh total belanja. Infrastruktur AI yang mengelola penyimpanan, retrieval, dan orkestrasi data untuk menghubungkan LLM dengan sistem perusahaan tercatat 1,5 miliar dolar AS.
Pola pembeliannya juga berubah. Menlo Ventures mencatat 76 persen use case AI pada 2025 dibeli, bukan dibangun sendiri, padahal pada 2024 komposisinya masih 47 persen dibangun dan 53 persen dibeli. Artinya, banyak perusahaan memilih aplikasi siap pakai yang di dalamnya sudah ada RAG, alih-alih membangun pipeline sendiri dari nol.
Data ini sejalan dengan pengalaman lapangan. Untuk mayoritas kebutuhan perusahaan, seperti chatbot layanan pelanggan, asisten pencarian dokumen internal, atau penjawab pertanyaan kebijakan HR, masalah utamanya adalah model tidak tahu informasi perusahaan. Masalah itu diselesaikan dengan memberi konteks yang tepat, bukan dengan mengubah cara model berpikir.
Ada juga temuan Menlo Ventures yang patut dicatat tim pengadaan. Ketika perusahaan sudah serius mengeksplorasi solusi AI, 47 persen kesepakatan AI berlanjut ke produksi, dibandingkan 25 persen untuk perangkat lunak SaaS tradisional. Kecepatan itu menggoda, tetapi juga berisiko bila arsitektur kustomisasi dipilih tergesa-gesa dan baru dievaluasi setelah sistem dipakai pelanggan.
Perlu dicatat, angka Menlo Ventures dihimpun perusahaan modal ventura asal Amerika Serikat dan bukan potret langsung Indonesia. Meski begitu, arahnya relevan karena perusahaan Indonesia memakai model dan platform yang sama, dari OpenAI, Anthropic, Google, sampai Amazon Web Services. Tren global ini menjadi patokan yang wajar untuk menyusun rencana kustomisasi di dalam negeri.
Bagi tim pengadaan, temuan ini bisa diterjemahkan menjadi pertanyaan untuk vendor. Tanyakan teknik kustomisasi apa yang dipakai produk mereka, bagaimana dokumen perusahaan diindeks, di mana indeks itu disimpan, dan apa yang terjadi pada data bila kontrak berakhir. Vendor yang serius akan bisa menjelaskan arsitektur retrieval-nya, bukan sekadar menyebut bahwa produknya "sudah dilatih dengan data Anda".
Kapan RAG Menjadi Pilihan yang Tepat?
RAG paling tepat ketika jawaban bergantung pada informasi yang sering berubah, harus bisa ditelusuri ke dokumen sumber, atau hanya boleh dilihat oleh pengguna tertentu. Contohnya katalog produk, kebijakan internal, kontrak, regulasi, dan basis pengetahuan layanan pelanggan. Pembaruan cukup dilakukan dengan mengganti dokumen di indeks, tanpa melatih ulang model.
Amazon Web Services merangkum fungsi ini dengan jelas di dokumentasi Amazon Bedrock Knowledge Bases. Menurut AWS, RAG adalah teknik yang memakai informasi dari sumber data untuk meningkatkan relevansi dan akurasi jawaban, dan memungkinkan perusahaan memasukkan informasi milik sendiri ke aplikasi AI generatif. Saat pertanyaan masuk, knowledge base mencari data yang relevan, lalu hasilnya dipakai untuk memperbaiki jawaban.
Beberapa kondisi yang menandakan RAG adalah pilihan utama:
Informasi berubah lebih cepat dari siklus pelatihan. Harga, stok, promo, dan prosedur yang diperbarui mingguan atau bulanan lebih mudah dikelola sebagai dokumen daripada sebagai bobot model.
Jawaban wajib menyebut sumber. Sektor keuangan, kesehatan, dan hukum butuh jejak dokumen. RAG bisa menampilkan potongan asal jawaban sehingga petugas bisa memeriksa ulang.
Hak akses berbeda per pengguna. Dokumen direksi, HR, dan staf lapangan tidak boleh tercampur. RAG bisa menyaring dokumen berdasarkan izin sebelum dikirim ke model.
Volume dokumen besar. Ribuan halaman SOP tidak muat di satu prompt, tetapi bisa diindeks dan diambil sebagian sesuai pertanyaan.
Data pribadi harus bisa dihapus. Menghapus dokumen dari indeks jauh lebih sederhana daripada mencabut informasi yang sudah tertanam di bobot model.
Kualitas RAG sangat bergantung pada tahap retrieval. Anthropic (2024) menunjukkan masalah klasik: potongan berbunyi "pendapatan perusahaan naik 3 persen dari kuartal sebelumnya" tidak menyebut perusahaan mana dan periode apa, sehingga sulit ditemukan dan mudah disalahartikan. Teknik Contextual Retrieval yang mereka usulkan menambahkan konteks pendek berisi 50 sampai 100 token ke setiap potongan sebelum diindeks. Hasilnya, kegagalan retrieval turun 49 persen, dan turun 67 persen bila dikombinasikan dengan reranking.
Pelajaran dari angka itu sederhana. RAG bukan sekadar memasang vector database lalu selesai. Cara memotong dokumen, metadata yang disertakan, metode pencarian, dan urutan ulang hasil menentukan apakah chatbot menjawab tepat atau malah mengarang dengan percaya diri.
Konteks Indonesia menambah tantangan tersendiri. Banyak dokumen perusahaan masih berupa PDF hasil pindaian, tabel di lembar kerja, atau campuran bahasa Indonesia dan Inggris dalam satu halaman. Sebelum diindeks, dokumen seperti ini perlu dibersihkan, diubah menjadi teks yang terbaca mesin, dan diberi metadata seperti nama unit, tanggal berlaku, dan tingkat kerahasiaan. Tahap persiapan ini sering memakan porsi kerja terbesar dalam proyek RAG.
Kapan Fine-Tuning Masih Layak Dipakai?
Fine-tuning layak dipakai ketika tugasnya sempit, berulang dalam volume tinggi, dan tersedia data berlabel yang cukup. Contohnya mengklasifikasi tiket keluhan ke kategori baku, mengekstrak kolom tertentu dari dokumen, atau menulis dengan gaya merek yang sangat konsisten. Di kasus seperti ini, yang perlu diubah adalah perilaku model, bukan pengetahuannya.
Google Cloud memberi rumusan yang lugas di dokumentasi Vertex AI: "Supervised fine-tuning is a good option when you have a well-defined task with available labeled data." Dokumentasi yang sama menambahkan bahwa teknik ini efektif untuk aplikasi domain khusus ketika bahasa atau kontennya sangat berbeda dari data yang dipakai melatih model besar. Klasifikasi, ringkasan, tanya jawab ekstraktif, dan percakapan disebut sebagai jenis tugas yang bisa ditingkatkan.
Ada syarat teknis yang perlu dipahami sebelum memulai. Untuk Gemini 3.5 Flash dan Gemini 3.5 Flash-Lite, Google mencatat batas 131.072 token input dan output per contoh pelatihan, ukuran file dataset pelatihan maksimal 1 GB dalam format JSONL, dan dataset validasi maksimal 5.000 contoh. Google juga menulis bahwa supervised fine-tuning bukan layanan yang dicakup Service Level Agreement, sehingga tidak ada jaminan tingkat layanan untuk proses pelatihannya.
Fine-tuning juga bisa memangkas biaya inferensi pada tugas yang sangat sering dijalankan. Model kecil yang sudah dilatih untuk satu tugas kadang menyamai model besar yang diberi prompt panjang. Google bahkan menyarankan agar model Gemini 3 ke atas yang sudah di-fine-tune dijalankan dengan thinking level MINIMAL, karena model belajar langsung dari data pelatihan dan tidak lagi memerlukan proses berpikir panjang untuk tugas tersebut.
Namun, fine-tuning punya batas yang sering diabaikan. Pertama, ia tidak cocok untuk fakta yang berubah, karena setiap pembaruan berarti pelatihan ulang. Kedua, model hasil fine-tuning tetap bisa berhalusinasi tentang hal di luar data pelatihannya. Ketiga, seperti terlihat pada jadwal OpenAI, model hasil fine-tuning ikut pensiun bersama model dasarnya, sehingga perusahaan harus mengulang pelatihan di model baru.
Karena itu, banyak tim memakai keduanya sekaligus. Fine-tuning dipakai untuk membentuk format dan gaya, lalu RAG menyuplai fakta terbaru. Makalah Lewis dan rekan-rekan (2020) sendiri sebenarnya membahas resep fine-tuning untuk model RAG, bukti bahwa kedua teknik ini sejak awal tidak dirancang untuk saling meniadakan.
Berapa Biaya dan Usaha Perawatan Masing-Masing?
RAG memerlukan biaya awal untuk membersihkan dan mengindeks dokumen, lalu biaya rutin berupa penyimpanan vektor dan token konteks di setiap pertanyaan. Fine-tuning memerlukan biaya menyiapkan data berlabel, menjalankan pelatihan, mengevaluasi hasil, dan mengulang semuanya ketika model dasar diganti. Biaya terbesar keduanya sering justru ada di tenaga kerja, bukan di tagihan API.
Di sisi RAG, komponen biayanya relatif mudah dipetakan. Ada biaya membuat embedding untuk semua dokumen, biaya vector database, dan biaya token tambahan karena potongan dokumen ikut dikirim ke model. Anthropic (2024) mencatat bahwa prompt caching bisa memangkas latensi lebih dari 2 kali dan biaya hingga 90 persen untuk prompt yang dipakai berulang. Teknik seperti ini membuat RAG dengan konteks besar tetap terjangkau.
Di sisi fine-tuning, biaya tersembunyi ada pada data. Contoh berlabel harus dibuat atau diperiksa manusia yang paham bisnisnya, misalnya staf layanan pelanggan senior atau analis kredit. Setiap kali kategori bisnis berubah, label lama perlu ditinjau. Tim juga harus menyimpan dataset dan skrip pelatihan dengan rapi agar bisa dipakai lagi saat model dasar pensiun, seperti yang akan dialami pengguna GPT-4o hasil fine-tuning pada 14 Januari 2027.
Berikut perbandingan ringkas dari sisi pengelolaan:
Waktu sampai produksi. RAG bisa diuji dalam hitungan hari dengan layanan terkelola seperti Amazon Bedrock Knowledge Bases. Fine-tuning butuh waktu tambahan untuk menyiapkan dan memvalidasi data berlabel.
Pembaruan informasi. RAG cukup mengganti dokumen. Fine-tuning perlu pelatihan ulang.
Ketergantungan penyedia. Indeks RAG bisa dipakai dengan model lain. Model fine-tuned terikat pada model dasar dan platform tempat ia dilatih.
Kebutuhan keahlian. RAG butuh keahlian rekayasa data dan pencarian. Fine-tuning butuh keahlian menyusun dataset dan evaluasi model.
Apa pun pilihannya, evaluasi adalah biaya yang tidak boleh dipotong. Panduan model optimization OpenAI menyarankan menulis evals lebih dulu untuk mengukur keluaran model dan menetapkan baseline, bahkan sebelum menulis prompt, mirip pendekatan behavior-driven development. Tanpa set evaluasi, perusahaan tidak bisa membuktikan bahwa RAG atau fine-tuning benar-benar memperbaiki hasil, dan tidak bisa memastikan kualitas tetap terjaga saat berpindah model.
Gambaran sederhananya begini. Perusahaan asuransi yang ingin chatbot menjawab pertanyaan polis cukup memperbarui dokumen polis di indeks setiap kali produk berubah, dan biaya bulanannya mengikuti jumlah pertanyaan. Bila perusahaan yang sama memilih fine-tuning untuk kebutuhan itu, setiap perubahan produk berarti menyusun contoh baru, melatih ulang, dan menguji ulang. Selisih usaha ini yang membuat RAG lebih ekonomis untuk pengetahuan yang terus bergerak.
Apa Risiko Keamanan RAG Menurut OWASP?
OWASP memasukkan "Vector and Embedding Weaknesses" sebagai risiko LLM08 dalam OWASP Top 10 for LLM Applications 2025. Menurut OWASP, kelemahan dalam cara vektor dan embedding dibuat, disimpan, atau diambil bisa dimanfaatkan untuk menyisipkan konten berbahaya, memanipulasi keluaran model, atau mengakses informasi sensitif. Risiko ini melekat pada hampir semua sistem RAG.
OWASP merinci beberapa bentuk ancaman. Yang pertama adalah akses tanpa izin dan kebocoran data, ketika kontrol akses yang longgar membuat embedding berisi informasi sensitif bisa diambil oleh pengguna yang tidak berhak. Yang kedua adalah kebocoran lintas konteks di lingkungan multi-tenant, ketika beberapa kelompok pengguna berbagi vector database yang sama sehingga dokumen satu kelompok bisa muncul di jawaban kelompok lain.
Ancaman ketiga adalah serangan inversi embedding, yaitu upaya membalik vektor untuk memulihkan sebagian besar informasi sumbernya. Ancaman keempat adalah peracunan data. OWASP memberi contoh sistem rekrutmen berbasis RAG yang menerima resume dengan teks tersembunyi berwarna putih di atas latar putih, berisi perintah agar sistem mengabaikan instruksi sebelumnya dan merekomendasikan kandidat tersebut. Model yang membaca resume itu bisa ikut termanipulasi.
Untuk skenario resume beracun itu, OWASP menyarankan alat ekstraksi teks yang mengabaikan format dan mampu mendeteksi konten tersembunyi, serta validasi semua dokumen masukan sebelum ditambahkan ke basis pengetahuan. Saran ini relevan bagi perusahaan Indonesia yang mulai memakai AI untuk menyaring lamaran kerja, proposal mitra, atau dokumen tender dari pihak luar.
OWASP juga menawarkan mitigasi yang konkret untuk tim TI:
Kontrol akses berbasis izin. Pakai vector database yang sadar izin dan pisahkan dataset secara logis per kelompok pengguna.
Validasi sumber data. Terima dokumen hanya dari sumber tepercaya dan audit basis pengetahuan secara rutin untuk mencari kode tersembunyi atau data yang diracuni.
Klasifikasi dan tag data. Beri label tingkat kerahasiaan pada setiap dokumen agar sistem tahu siapa yang boleh menerima potongannya.
Pemantauan dan log. Simpan catatan aktivitas retrieval yang tidak bisa diubah untuk mendeteksi perilaku mencurigakan.
Fine-tuning tidak bebas risiko. OWASP mencatat risiko LLM04:2025 Data and Model Poisoning, yang terjadi ketika data pra-pelatihan, fine-tuning, atau embedding dimanipulasi untuk memasukkan celah, pintu belakang, atau bias. Bedanya, kesalahan di indeks RAG bisa dihapus dengan membuang dokumen, sedangkan kesalahan yang sudah masuk bobot model menuntut pelatihan ulang. Bagi perusahaan Indonesia yang memakai chatbot untuk melayani publik, perbedaan waktu pemulihan ini bisa menentukan besar kecilnya kerugian reputasi.
Bagaimana UU PDP Memengaruhi Pilihan RAG atau Fine-Tuning?
Undang-Undang Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi berlaku untuk RAG maupun fine-tuning setiap kali data pribadi ikut diproses. UU ini diundangkan pada 17 Oktober 2022 dengan masa penyesuaian paling lama 2 tahun. Konsekuensinya, pengendali data harus bisa memenuhi hak subjek data, termasuk hak menghapus, di sistem AI mana pun yang dipakai.
Pasal 8 UU PDP berbunyi: "Subjek Data Pribadi berhak untuk mengakhiri pemrosesan, menghapus, dan/atau memusnahkan Data Pribadi tentang dirinya sesuai dengan ketentuan peraturan perundang-undangan." Pasal 16 ayat (1) juga memasukkan penghapusan atau pemusnahan sebagai bagian dari pemrosesan data pribadi. Hak ini lebih mudah dipenuhi di arsitektur RAG, karena dokumen yang memuat data seseorang bisa dicari lalu dihapus dari indeks. Di model hasil fine-tuning, data yang sudah membentuk bobot tidak bisa dicabut satu per satu tanpa melatih ulang model.
Pasal 34 ayat (1) mewajibkan pengendali data melakukan penilaian dampak pelindungan data pribadi bila pemrosesan berpotensi berisiko tinggi. Ayat (2) menyebut contoh risiko tinggi, di antaranya pengambilan keputusan otomatis yang berakibat hukum atau berdampak signifikan, pemrosesan data pribadi yang bersifat spesifik, pemrosesan dalam skala besar, serta evaluasi, penskoran, atau pemantauan yang sistematis. Chatbot yang membaca riwayat nasabah atau sistem penyaringan kandidat karyawan bisa masuk kategori ini.
Pasal 10 memberi subjek data hak mengajukan keberatan atas keputusan yang hanya didasarkan pada pemrosesan otomatis, termasuk pemrofilan, yang menimbulkan akibat hukum atau berdampak signifikan. Artinya, sistem AI yang dipakai untuk menyetujui kredit atau menolak pelamar perlu menyediakan jalur peninjauan manusia, apa pun teknik kustomisasinya.
Sanksinya tidak ringan. Pasal 57 menyebut sanksi administratif berupa peringatan tertulis, penghentian sementara pemrosesan, penghapusan atau pemusnahan data pribadi, dan denda administratif. Denda administratif paling tinggi 2 persen dari pendapatan tahunan atau penerimaan tahunan terhadap variabel pelanggaran. Bagi perusahaan menengah ke atas, angka ini cukup besar untuk membuat desain kepatuhan menjadi bagian dari arsitektur, bukan tambahan di akhir proyek.
Praktik yang aman adalah meminimalkan data pribadi di kedua jalur. Untuk RAG, simpan data pribadi hanya bila perlu, terapkan kontrol akses per pengguna, dan siapkan prosedur hapus dari indeks. Untuk fine-tuning, anonimkan atau samarkan data sebelum dipakai melatih, dan dokumentasikan sumber setiap contoh pelatihan agar penilaian dampak bisa dipertanggungjawabkan.
Langkah Memilih Kustomisasi AI untuk Perusahaan Indonesia
Urutan yang paling aman adalah mengukur dulu, lalu menambah kerumitan hanya bila terbukti perlu. Mulailah dengan set evaluasi dan prompt yang baik, tambahkan RAG ketika model kekurangan pengetahuan perusahaan, lalu pertimbangkan fine-tuning untuk tugas sempit yang tetap gagal setelah dua langkah pertama. Urutan ini sejalan dengan alur model optimization yang dianjurkan OpenAI, yaitu evals, prompt, lalu fine-tuning.
Langkah praktisnya dapat disusun sebagai berikut:
Tetapkan tugas dan ukuran keberhasilan. Tulis 50 sampai 200 pertanyaan nyata beserta jawaban yang benar menurut tim bisnis. Inilah set evaluasi yang akan dipakai di semua tahap.
Uji prompt di beberapa model. Bandingkan model dari dua atau tiga penyedia dengan prompt yang sama. Panduan OpenAI menyebut proses prompt engineering bisa saja sudah cukup untuk hasil yang baik.
Diagnosis jenis kesalahan. Bila model salah karena tidak tahu informasi perusahaan, arahkan ke RAG. Bila model tahu tetapi format atau gayanya salah, arahkan ke perbaikan prompt atau fine-tuning.
Bangun RAG dengan kontrol akses sejak awal. Pilih cara memotong dokumen, tambahkan metadata, dan terapkan izin per kelompok pengguna sesuai rekomendasi OWASP.
Lakukan penilaian dampak bila memproses data pribadi. Ikuti Pasal 34 UU PDP untuk pemrosesan berisiko tinggi dan siapkan prosedur hapus data.
Pertimbangkan fine-tuning dengan rencana keluar. Simpan dataset dan skrip pelatihan dalam format portabel seperti JSONL, catat model dasar dan tanggal pensiunnya, serta siapkan anggaran pelatihan ulang.
Pilihan platform juga perlu dipikirkan dari sisi kedaulatan data. Perusahaan yang tunduk pada aturan sektor, seperti perbankan atau layanan kesehatan, perlu memastikan lokasi penyimpanan indeks vektor dan data pelatihan sesuai kebijakan internal dan regulator sektornya. Layanan terkelola dari penyedia cloud besar memudahkan, tetapi kontrak dan konfigurasi region tetap harus diperiksa tim hukum dan TI.
Terakhir, jangan anggap keputusan ini permanen. Jadwal penghentian model bergerak setiap beberapa bulan, seperti terlihat dari pengumuman OpenAI pada 14 Oktober 2026. Perusahaan yang punya set evaluasi, indeks dokumen yang rapi, dan dataset pelatihan yang terdokumentasi bisa berpindah model dalam hitungan minggu. Perusahaan yang tidak punya ketiganya terpaksa memulai dari nol setiap kali penyedia mengubah layanan.
Mulailah dari skala kecil. Pilih satu unit kerja dengan masalah yang jelas, misalnya tim layanan pelanggan yang setiap hari menjawab pertanyaan berulang, lalu ukur hasil dengan set evaluasi yang sama sebelum dan sesudah RAG dipasang. Bila angkanya membaik dan risiko data terkendali, perluas ke unit lain. Pendekatan bertahap ini membuat investasi AI bisa dipertanggungjawabkan kepada direksi dengan bukti, bukan janji.
Kesimpulan
RAG dan fine-tuning menjawab masalah yang berbeda. RAG memberi model pengetahuan yang segar, bisa ditelusuri, dan bisa dihapus, sehingga cocok untuk sebagian besar kebutuhan perusahaan Indonesia, dari layanan pelanggan sampai pencarian dokumen internal. Fine-tuning membentuk perilaku model untuk tugas sempit yang berulang, tetapi menuntut data berlabel, pelatihan ulang, dan rencana migrasi, apalagi setelah OpenAI membatasi fine-tuning mandiri sepanjang 2026.
Langkah terbaik untuk 2026 dan 2027 adalah membangun fondasi yang bisa dibawa ke mana saja: set evaluasi, basis pengetahuan RAG yang aman sesuai rekomendasi OWASP, dan tata kelola data pribadi yang patuh UU PDP. Dengan fondasi itu, perusahaan bebas memilih model terbaik di pasar, menambah fine-tuning bila memang terbukti perlu, dan tetap tenang ketika penyedia mengumumkan perubahan berikutnya.
(Burung Hantu Infratek / Berbagai Sumber)
⚠️ Artikel ini seluruhnya diriset, ditulis, dan dikembangkan oleh AI internal Burung Hantu Infratek.
🦉 Burung Hantu Infratek adalah software house dan system integrator yang sudah berpengalaman lebih dari 5 tahun dalam pengembangan dan implementasi generative AI pada berbagai perusahaan dan institusi.
Sumber dan Referensi
[2] Model optimization - OpenAI API
[3] 2025: The State of Generative AI in the Enterprise - Menlo Ventures
[4] Introducing Contextual Retrieval - Anthropic
[5] About supervised fine-tuning for Gemini models - Google Cloud
[6] Retrieve data and generate AI responses with Amazon Bedrock Knowledge Bases - AWS
[7] LLM08:2025 Vector and Embedding Weaknesses - OWASP Gen AI Security Project
[8] Undang-Undang Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi - JDIH BPK
[9] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - arXiv