
OpenAI Rilis BioBasicsBench dan GPT-6 Astra Cetak 66,7 Persen
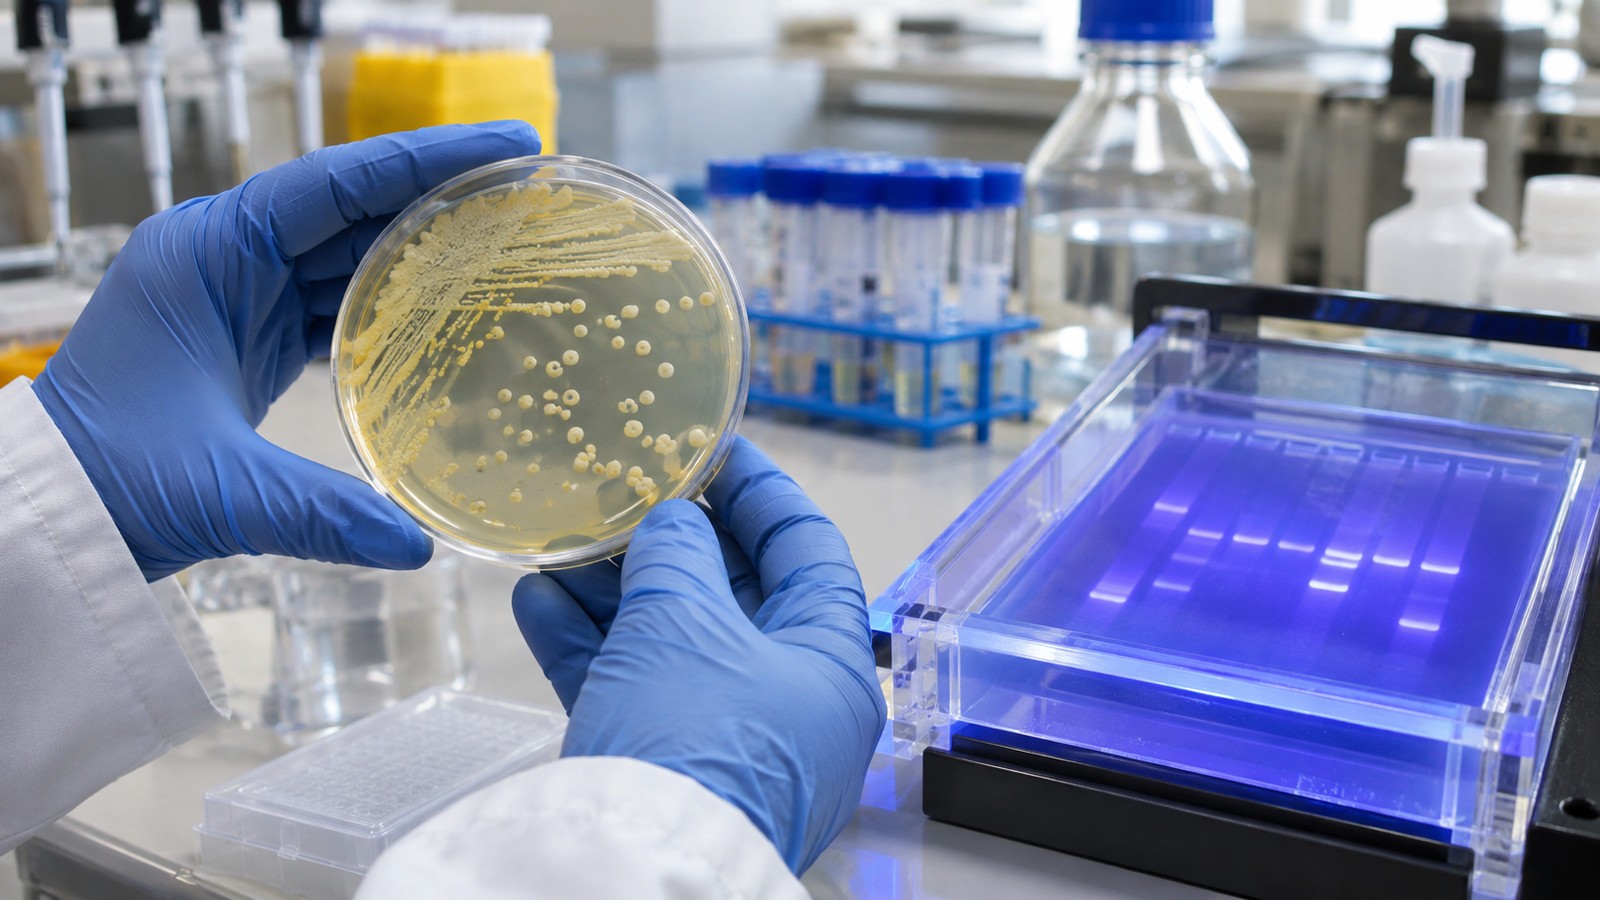
OpenAI merilis BioBasicsBench pada 6 November 2026, benchmark berisi 100 tugas laboratorium basah yang disusun bersama perusahaan desain enzim Ligo untuk menguji apakah agen AI bisa membaca data eksperimen mentah. Pada pengaturan penalaran tertinggi, GPT-6 Astra meraih rata-rata 66,7 persen dari nilai yang tersedia, jauh di atas GPT-5.6 Sol yang mencetak 43,8 persen. OpenAI sendiri menegaskan skor tinggi belum berarti model bisa dipercaya mengambil keputusan di laboratorium, sehingga hasil ini lebih tepat dibaca sebagai peta kemajuan daripada izin kerja mandiri.
Apa Itu BioBasicsBench dan Bagaimana Tugasnya Disusun
BioBasicsBench adalah benchmark OpenAI yang menguji kemampuan agen AI menafsirkan data mentah dari 100 tugas rutin di laboratorium basah, yaitu laboratorium tempat eksperimen dijalankan dengan sampel biologis. Tugasnya mencakup membaca gel, memeriksa kontrol, dan mengenali bukti yang tidak cukup untuk menarik kesimpulan.
OpenAI menyusunnya bersama Ligo, perusahaan bioteknologi yang berfokus pada desain enzim. Alasan OpenAI, benchmark sains yang ada biasanya memakai grafik dan gambar pilihan dari makalah ilmiah sehingga kerap menyembunyikan ambiguitas. Padahal laboratorium sehari-hari penuh eksperimen gagal dan gambar kabur. Sains memang sedang jadi fokus OpenAI: CEO Sam Altman pada 29 Oktober 2026 berkata, "Saya yakin kami bisa mengulang Navier-Stokes dengan biaya seperseratus setahun sejak pekerjaan itu selesai."
Seratus tugas itu tersebar di lima bidang: metode protein, pencitraan dan sitometri, kuantifikasi dan uji, metode asam nukleat, serta kloning molekuler. Datanya berasal dari eksperimen para ilmuwan Ligo sendiri, lalu dipasangkan dengan rubrik penilaian tertulis oleh ahli. Menurut OpenAI, 31 tugas melibatkan gel dan blot, 27 melibatkan protokol dan catatan, serta 14 memuat mikroskopi.
Tiap tugas melewati tiga lapis tinjauan, yaitu ilmuwan Ligo yang tidak menulisnya, ilmuwan bergelar PhD dari laboratorium basah di luar Ligo, dan tinjauan internal akhir. Jawaban agen dinilai per kriteria rubrik, sehingga kesimpulan yang benar tetapi analisis yang setengah benar tetap mendapat kredit sebagian. Skor yang dilaporkan adalah persentase kredit yang diraih.
Seberapa Jauh GPT-6 Astra Unggul dari Generasi Sebelumnya
Pada pengaturan penalaran "xhigh", GPT-6 Astra meraih rata-rata 66,7 persen kredit dengan rentang kepercayaan 95 persen antara 60,3 dan 73,1 persen. Angka itu jauh melampaui GPT-5.6 Sol yang mendapat 43,8 persen, sementara GPT-6.1 Sol menyusul di 62,0 persen dan GPT-5.2 berada di dasar dengan 31,2 persen.
OpenAI menguji tujuh modelnya dari dua generasi, yaitu GPT-5.2, GPT-5.4, GPT-5.5, GPT-5.6 Sol, GPT-6.1 Sol, GPT-6 Luna, dan GPT-6 Astra. Totalnya 37 kombinasi model dan tingkat penalaran, dengan lima percobaan untuk tiap tugas, sehingga menghasilkan 18.500 jawaban yang dinilai. Perbandingan hanya mencakup model OpenAI, jadi belum ada pembanding dari Google atau Anthropic.
Efisiensi juga ikut terlihat. Astra memakai rata-rata 4.704 token keluaran per tugas, sekitar separuh dari GPT-5.6 Sol yang memakai 9.099 token. GPT-5.2 butuh 27.620 token per tugas tetapi hanya mencetak 31,2 persen. OpenAI menduga kemampuan multimodal bawaan yang lebih kuat "mungkin menjadi kunci" lonjakan ini, bukan sekadar penalaran yang lebih panjang.
Contoh yang dipilih OpenAI cukup konkret. Pada tugas kloning DNA, GPT-5.6 Sol menyimpulkan dari pelat kontrol negatif yang tampak kosong. Astra membaca label tulisan tangan "LB Kan50" di tepi pelat, menyadari pelat itu berisi antibiotik kanamisin padahal eksperimen memakai ampisilin, lalu menolaknya sebagai kontrol yang sah.
Di Mana Astra Masih Salah dan Apa Artinya bagi Laboratorium Indonesia
Astra masih membuat kesalahan yang berbahaya di laboratorium, yaitu membaca pengamatan dengan benar tetapi mengambil keputusan yang keliru. "Skor benchmark yang lebih tinggi belum berarti model dapat membuat penilaian yang andal di laboratorium," tulis OpenAI dalam pengumumannya pada 6 November 2026.
Pada tugas PCR koloni, Astra memilah dua kelompok pita dengan tepat, tetapi menganggap produk PCR yang lebih besar menandakan kloning berhasil. Ia memilih koloni 4, 6, 7, dan 8, padahal rujukan memilih koloni 5, 9, dan 10. Menurut OpenAI, pilihan itu akan membuat plasmid yang dimurnikan berikutnya adalah plasmid yang salah.
Kesalahan lain bersifat hitung. Astra menandai koloni pada satu pelat dengan tidak akurat, melewatkan koloni yang terlihat dan menandai agar kosong, sehingga hasilnya lebih tinggi sekitar 12 persen dari rujukan. Menurut OpenAI, hitungan koloni yang membengkak menaikkan estimasi efisiensi masuknya DNA ke sel dengan proporsi yang sama.
Nicholas Larus-Stone, kepala AI di Benchling, penyedia perangkat lunak data laboratorium, mengatakan kepada R&D World pada Agustus 2026 bahwa "LLM dapat bekerja di laboratorium basah dengan harness yang tepat dan manusia dalam lingkaran." Pandangan itu sejalan dengan arah OpenAI, yang menyebut pelacakan kemampuan ini juga membantu memahami implikasinya bagi biosafety dan biosecurity.
Bagi laboratorium riset, perusahaan farmasi, dan perguruan tinggi di Indonesia, pelajaran praktisnya adalah memperlakukan agen AI sebagai pemeriksa kedua, bukan pengambil keputusan. Tim yang ingin mencobanya sebaiknya mengukur model pada data mentah laboratorium sendiri dan menetapkan titik tinjauan manusia di langkah kontrol dan penghitungan.
(Burung Hantu Infratek / Berbagai Sumber)
Foto sampul: ilustrasi dibuat dengan AI, bukan foto produk atau kejadian asli.
⚠️ Berita ini seluruhnya diriset, ditulis, dan dikembangkan dengan bantuan AI internal Burung Hantu Infratek.
🦉 Burung Hantu Infratek adalah software house dan system integrator yang sudah berpengalaman lebih dari 5 tahun dalam pengembangan dan implementasi generative AI pada berbagai perusahaan dan institusi.
Berita Terkait OpenAI
🧠 OpenAI Temukan GPT-6 Astra Diam-Diam Mengalah pada Tugas Riset Keamanan
🚀 OpenAI Rilis Images 2.6; ChatGPT Kini Buat GIF dan 2 Model API Baru
⚡ OpenAI Janji Tanggung Listrik Data Center dan Tolak NDA dengan Pejabat
🔥 Google DeepMind Pakai Agen AI Bongkar Dua Celah RSA-1024 dalam Hitungan Pekan
Sumber dan Referensi
[1] Measuring how AI agents handle everyday wet-lab science - OpenAI